連続安打はランダムと区別できるか (Albright 1993 の追試)
2026-08-15
追試する論文
S. C. Albright (1993). A Statistical Analysis of Hitting Streaks in Baseball. Journal of the American Statistical Association 88(424), 1175-1183.
「あの打者は当たっている」という感覚は本物か. Albright は1987-1990年の主力打者について, 打数ごとの安打・凡退の並びを取り出し, ランダムな並びと区別できるかを調べました.
主な道具はランズ検定です. 連 (runs) とは同じ結果が続く塊のことで, 連打しやすい打者なら連の数が少なくなるはずです.
Albright の結論は「区別できない」でした. ここでは手元にある全年で追試し, さらに この検定が何を見逃すかを検出力から確かめます.
library(data.table)
library(dplyr)
library(ggplot2)

MIN_AB <- 500L    # 「主力打者」の足切り

col_names <- fread("../../data/reference/retrosheet-columns.csv", header = FALSE)[[1]]
KEEP <- c("GAME_ID", "BAT_ID", "PIT_ID", "BAT_HAND_CD", "PIT_HAND_CD",
          "BAT_HOME_ID", "AB_FL", "H_FL", "BAT_EVENT_FL")
idx <- match(KEEP, col_names)

files <- list.files("../../data", pattern = "^all[0-9]{4}\\.csv$", full.names = TRUE)
if (!length(files)) stop("../../data に all<年>.csv がありません")
seasons <- as.integer(sub(".*all([0-9]{4})\\.csv$", "\\1", files))

dat <- rbindlist(Map(function(f, y) {
  x <- fread(f, select = idx, col.names = KEEP, showProgress = FALSE)
  # ファイル内の行順が試合内の時系列
  x[, seq := .I][BAT_EVENT_FL == "T" & AB_FL == "T"][, year := y][]
}, files, seasons))

dat[, hit := as.integer(H_FL > 0)]
dat[, date := substr(GAME_ID, 4, 11)]
setorder(dat, year, BAT_ID, date, GAME_ID, seq)
dat[, n_ab := .N, by = .(year, BAT_ID)]
9,424,720打数, 56,906の打者シーズンです. 四球や犠打は打数に入らないので, 論文と同じく打数だけを並べます.
連を数える
安打を1, 凡退を0とした並びで, 連の数 \(R\) を数えます. 安打数 \(n_1\) と凡退数 \(n_2\) を固定したとき, ランダムな並びなら
\[ E[R] = \frac{2 n_1 n_2}{n} + 1, \qquad V[R] = \frac{2 n_1 n_2 (2 n_1 n_2 - n)}{n^2 (n-1)} \]
なので, \(z = (R - E[R]) / \sqrt{V[R]}\) が標準正規に従うはずです. \(z\) が負なら連が少ない = 塊になっていることを意味します.
runs_z <- function(x) {
  n <- length(x); n1 <- sum(x); n2 <- n - n1
  if (n1 == 0L || n2 == 0L) return(NA_real_)
  R <- 1L + sum(x[-1] != x[-n])
  (R - (2 * n1 * n2 / n + 1)) / sqrt(2 * n1 * n2 * (2 * n1 * n2 - n) / (n^2 * (n - 1)))
}
実装が正しいか, 手で数えられる小さな例で確かめます.
# 1,0,1,0,1,0 は連が6つ (最大)。0,0,0,1,1,1 は連が2つ (最小)
stopifnot(runs_z(c(1,0,1,0,1,0)) > 0, runs_z(c(0,0,0,1,1,1)) < 0)
# R の tseries::runs.test と突き合わせる
set.seed(1); v <- rbinom(400, 1, 0.27)
ref <- suppressWarnings(tseries::runs.test(factor(v)))$statistic
ok_impl <- isTRUE(all.equal(unname(runs_z(v)), unname(ref), tolerance = 1e-8))
stopifnot(ok_impl)
tseries::runs.test と一致しました.
主張の再現
reg <- dat[n_ab >= MIN_AB]
z <- reg[, .(n_ab = .N, hits = sum(hit), avg = mean(hit), z = runs_z(hit)),
         by = .(year, BAT_ID)]

summarise_z <- function(d) {
  data.frame(打者シーズン = nrow(d),
             `zの平均` = sprintf("%+.4f", mean(d$z)),
             `zのSD` = sprintf("%.4f", sd(d$z)),
             `5%で有意` = sprintf("%.2f%%", 100 * mean(abs(d$z) > 1.96)),
             check.names = FALSE)
}| 期間 | 打者シーズン | zの平均 | zのSD | 5%で有意 |
|---|---|---|---|---|
| 1987-1990 (論文と同じ窓) | 368 | -0.0429 | 0.9690 | 4.35% |
| 1938-2013 (全期間) | 5733 | -0.0474 | 0.9938 | 4.94% |
Albright の結論はそのまま再現しました. 論文と同じ1987-1990年では368の打者シーズンのうち 4.35%が5%水準で有意で, 偶然の期待値5%と変わりません.
1938-2013年に広げても4.94%です. 5733の打者シーズンを見ても, 個々の打者の連打はランダムと区別できません.
ggplot(z, aes(x = z)) +
  geom_histogram(aes(y = after_stat(density)), bins = 50, alpha = 0.7) +
  stat_function(fun = dnorm, colour = "red", linewidth = 1) +
  labs(x = "ランズ検定の z", y = NULL,
       title = sprintf("z の分布と標準正規 (赤線), %d-%d年", min(seasons), max(seasons))) +
  theme_minimal()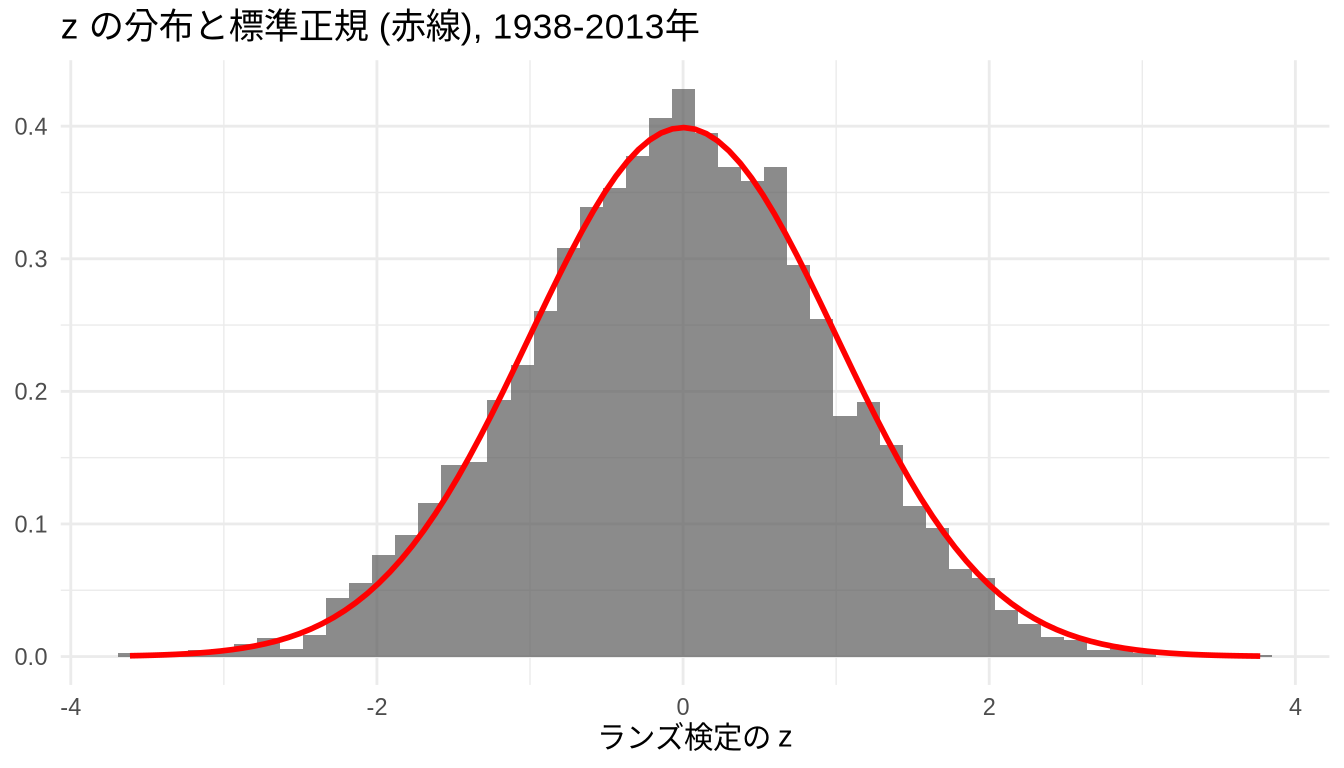
わずかなずれ
分布はきれいに重なります. ただし平均を見ると少しだけ0からずれています.
se_z <- sd(z$z) / sqrt(nrow(z))
t_z  <- mean(z$z) / se_z
平均は-0.0474, 標準誤差0.0131で, t = -3.61です. 打者1人ずつでは見えないが, 5,733人ぶん集めると 連はわずかに少ない (塊になっている).
これは連続性の証拠でしょうか. 別の説明があります. 同じ打者でも1打数ごとに安打の確率は違います. 弱い投手に4打数当たった日は確率が高く, エースの日は低い. 確率が動くだけで, 連続性がまったく無くても連は少なくなります.
塊は相手のばらつきで説明できるか
打者の実力と相手投手の実力を合成した確率 (log5) を打数ごとに作り, 連続性をゼロにしたまま並びを生成して, 同じ検定にかけます.
dat[, bat_avg := mean(hit), by = .(year, BAT_ID)]
pit <- dat[, .(pit_ab = .N, pit_avg = mean(hit)), by = .(year, PIT_ID)]
dat[pit, on = .(year, PIT_ID), `:=`(pit_avg = i.pit_avg, pit_ab = i.pit_ab)]
lgv <- dat[, .(lg = mean(hit)), by = year]
dat[lgv, on = "year", lg := i.lg]

# log5: 打者 b と投手 p の対戦で期待される打率
dat[, p_hat := {
  pp <- fifelse(pit_ab >= 100, pit_avg, lg)
  o <- (bat_avg / (1 - bat_avg)) * (pp / (1 - pp)) / (lg / (1 - lg))
  o / (1 + o)
}]
# 左右の相性とホーム/ビジターのぶんを足す
dat[, `:=`(same = BAT_HAND_CD == PIT_HAND_CD, home = BAT_HOME_ID == 1L)]
adj <- dat[, .(m = mean(hit)), by = .(same, home)][, delta := m - dat[, mean(hit)]]
dat[adj, on = .(same, home), p_hat := p_hat + i.delta]
dat[, p_hat := pmin(0.95, pmax(0.02, p_hat))]
reg <- dat[n_ab >= MIN_AB]
NSIM <- 5L
sim_z <- function(pcol, seed) {
set.seed(seed)
reg[, sim := as.integer(runif(.N) < get(pcol))]
s <- reg[, .(z = runs_z(sim)), by = .(year, BAT_ID)]
c(mean = mean(s$z), rej = 100 * mean(abs(s$z) > 1.96))
}
het <- sapply(seq_len(NSIM), function(k) sim_z("p_hat", k)) # 相手のばらつきあり
hom <- sapply(seq_len(NSIM), function(k) sim_z("bat_avg", 100 + k)) # 打率だけ (同質)| データ | zの平均 | 5%で有意 |
|---|---|---|
| 実データ | -0.0474 | 4.94% |
| 生成: 相手のばらつきあり, 連続性なし | -0.0527 | 5.01% |
| 生成: 打者の打率だけ (完全に同質) | -0.0011 | 5.02% |
相手のばらつきだけで, 実データのずれが再現します. 連続性をまったく入れていない並びでも z の平均は-0.0527で, 実データの-0.0474とほぼ同じです. 一方, 打率だけの同質な並びでは-0.0011とほぼ0に戻ります.
つまりわずかな塊は, 調子の波ではなく対戦相手の入れ替わりの産物です. Albright が状況変数を入れた回帰も併用したのは, この点を潰すためでした.
この検定は何を見逃すか
「有意にならなかった」は「効果が無い」ではありません. どれくらいの効果なら検出できるのかを測ります.
連続性のある並びを作ります. 直近25打数の打率が自分の平均より高いほど, 次の安打確率を上げます.
sim_streaky <- function(n, p, b, W = 25L) {
  out <- integer(n); q <- integer(W); s <- 0L; filled <- 0L
  u <- runif(n)
  for (i in seq_len(n)) {
    m <- if (filled >= W) s / W else p
    v <- as.integer(u[i] < min(0.95, max(0.02, p + b * (m - p))))
    out[i] <- v
    j <- (i - 1L) %% W + 1L
    if (filled >= W) s <- s - q[j]
    q[j] <- v; s <- s + v
    if (filled < W) filled <- filled + 1L
  }
  out
}

power_of <- function(b, seed = 7) {
  set.seed(seed)
  zz <- vapply(seq_len(nrow(z)), function(i)
    runs_z(sim_streaky(z$n_ab[i], z$avg[i], b)), numeric(1))
  c(mean = mean(zz), rej = 100 * mean(abs(zz) > 1.96))
}
効果の大きさは打者の実力のばらつきを単位にします.
ba_sd <- sd(z$avg)             # 主力打者の打率のSD
targets <- c(0, 0.13, 0.5, 1.0)
# 直近25打数の打率が ±0.10 動いたときの安打確率の差が target*ba_sd になるよう b を決める
bs <- targets * ba_sd / 0.20
pw <- sapply(bs, power_of)| 連続性の強さ | b | zの平均 | 5%で有意になる割合 |
|---|---|---|---|
| なし | 0.000 | -0.0054 | 4.64% |
| 0.13 SD | 0.017 | -0.0211 | 4.81% |
| 0.50 SD | 0.067 | -0.0637 | 5.13% |
| 1.00 SD | 0.133 | -0.1252 | 5.55% |
検出力がほとんどありません. 実力の0.5標準偏差ぶんという大きな連続性を入れても, 有意になるのは5.13%で, 連続性がまったく無いとき (4.64%) と区別できません.
打者1人のシーズンは500打数程度しかありません. この長さの二値列から, 1打数あたり数パーセントの確率の揺れを取り出すのは無理です.
Albright は何を示したのか
| 論文の主張 | 手元の結果 | 判定 |
|---|---|---|
| 個々の打者の連打はランダムと区別できない | 4.94% が有意 (期待5%), 1938-2013年 5,733打者シーズン | 再現した |
| z の分布は標準正規に近い | 平均 -0.0474, SD 0.9938 | 再現した |
| (この検定で) 連続性の証拠は無い | 同意. ただし 0.5 SD の連続性でも検出率は 5.13% | 再現したが解釈に注意 |
Albright の分析は正しく再現できます. ただし結論の言い方には注意が要ります. この検定が示したのは「連続性は無い」ではなく, 「この道具では見えない」です.
ホットハンドは実在するのかでは, 打席単位のデータを大量に重ねることで, 実力の0.1標準偏差ほどの 小さな連続性を取り出しました (数値はあちらの記事で計算しています). その大きさの連続性をこのランズ検定にかけると, 上の表のとおり 有意になるのは4.81%で, 連続性がまったく無いとき (4.64%) と区別できません.
2本の論文は矛盾していません. 見ている解像度が違います.
- Albright: 打者1人のシーズンを1つの並びとして見る → 何も見えない
- Green & Zwiebel: 全打者の全打席を重ねる → 小さな効果が見える
そして見えた効果は, ホットハンドの記事で示したとおり, 論文が報告した大きさよりずっと小さいものでした.
注意
- 対象は500打数以上の打者シーズンです. この足切りを下げると打者シーズンは増えますが, 1本の並びが短くなり, 検出力はさらに落ちます.
- 打数だけを並べています. 四球や犠打は飛ばしているので, 「4打数無安打だが四球2つ」の日は3打数ぶんの並びになります.
- 並びは日付順です. 同じ日のダブルヘッダーは
GAME_IDの末尾で区別しています. - log5 は打者と投手の実力を合成する標準的な近似ですが, 球場や気温は入っていません. 相手のばらつきを過小に見積もっている可能性があり, その場合「塊は相手のばらつきで説明できる」はより強く成り立ちます.
- 検出力の計算は「直近25打数で調子が決まる」という形を仮定しています. 別の形の連続性 (例えば数試合単位で切り替わる) なら結果は変わります.