ホットハンドは実在するのか (Green & Zwiebel 2018 の追試)
2026-08-15
追試する論文
B. Green and J. Zwiebel (2018). The Hot-Hand Fallacy: Cognitive Mistakes or Equilibrium Adjustments? Evidence from Major League Baseball. Management Science 64(11), 5315-5348.
ホットハンド (調子の波) は無い, というのが長年の定説でした. この論文はそれをひっくり返します. retrosheet の2000-2011年の打席データで, 調べた10の指標すべてでホットハンドが見つかったと報告しました.
大きさも主張しています. 「調子がいい」ことの効果は, 打者の能力のばらつきの0.5〜1標準偏差に相当する. これは並の打者と一流打者の差に匹敵します.
論文の測り方はこうです.
- 調子 = 直近25打席の成績
- 基準 = そのシーズンの成績. ただし当該打席の前後25打席 (計50打席) を除く
- 相手投手の質, 左右の相性, 球場を統制する
ここでは論文と同じ2000-2011年で追試します. そのうえで, この測り方そのものが見かけの効果を作らないかを確かめます.
library(data.table)
library(dplyr)
library(ggplot2)

W <- 25L                 # 論文と同じ窓の長さ
YEARS <- 2000:2011       # 論文と同じ期間

col_names <- fread("../../data/reference/retrosheet-columns.csv", header = FALSE)[[1]]
KEEP <- c("GAME_ID", "BAT_ID", "PIT_ID", "BAT_HAND_CD", "PIT_HAND_CD",
          "BAT_HOME_ID", "EVENT_CD", "BAT_EVENT_FL", "AB_FL", "H_FL")
idx <- match(KEEP, col_names)

dat <- rbindlist(lapply(YEARS, function(y) {
  f <- sprintf("../../data/all%d.csv", y)
  if (!file.exists(f)) stop("../../data に all", y, ".csv がありません")
  x <- fread(f, select = idx, col.names = KEEP, showProgress = FALSE)
  # ファイル内の行順が試合内の時系列。打席として成立した行だけ残す前に控えておく
  x[, seq := .I][BAT_EVENT_FL == "T"][, year := y][]
}))
出塁 (安打・四球・死球) を結果とします. 打率より事象が多く, 推定が安定します.
dat[, onbase := as.integer(EVENT_CD %in% c(14L, 15L, 16L, 20L, 21L, 22L, 23L))]
# GAME_ID は <チーム><YYYYMMDD><番号>。日付で並べてから試合内の行順で並べる
dat[, date := substr(GAME_ID, 4, 11)]
setorder(dat, year, BAT_ID, date, GAME_ID, seq)
dat[, pa_i := seq_len(.N), by = .(year, BAT_ID)]   # 打者のシーズン内での打席番号
dat[, n_pa := .N, by = .(year, BAT_ID)]
2,248,334打席, 11,476の打者シーズンです.
投手の質はシーズン被出塁率で測ります.
pq <- dat[, .(BF = .N, ob = mean(onbase)), by = .(year, PIT_ID)]
dat[pq, on = .(year, PIT_ID), `:=`(pit_ob = i.ob, pit_bf = i.BF)]
dat[, `:=`(same_hand = as.integer(BAT_HAND_CD == PIT_HAND_CD),
           home = as.integer(BAT_HOME_ID == 1L), yearf = factor(year))]
dat[, pit_g := factor(cut(pit_ob, quantile(pit_ob, 0:9 / 9, na.rm = TRUE),
                          labels = FALSE, include.lowest = TRUE))]
調子と基準を作る
add_streak <- function(d) {
  setorder(d, year, BAT_ID, pa_i)
  # 調子: 直前W打席の平均 (現在の打席は含めない)
  d[, hot := shift(frollsum(y, W), 1L) / W, by = .(year, BAT_ID)]
  d[, tot := sum(y), by = .(year, BAT_ID)]
  d[, lo := pmax(1L, pa_i - W)]
  d[, hi := pmin(n_pa, pa_i + W)]
  d[, cs := cumsum(y), by = .(year, BAT_ID)]
  # 前後W打席の合計 (端では取れる範囲だけ)
  d[, win_sum := { c0 <- c(0, cs); c0[hi + 1L] - c0[lo] }, by = .(year, BAT_ID)]
  # 論文の基準: 前後W打席を除いたシーズン平均
  d[, base_excl := (tot - win_sum) / (n_pa - (hi - lo + 1L))]
  # 比較用: 窓を除かないシーズン平均 (当該打席だけ除く)
  d[, base_full := (tot - y) / (n_pa - 1L)]
  d[]
}
dat[, y := onbase]
dat <- add_streak(dat)
書いた通りに計算できているか, 打者1人を取り出して手で数え直します.
big <- dat[n_pa >= 600][1]
one <- dat[year == big$year & BAT_ID == big$BAT_ID][order(pa_i)]
i <- 300L
lo <- max(1L, i - W); hi <- min(nrow(one), i + W)
chk_base <- (sum(one$y) - sum(one$y[lo:hi])) / (nrow(one) - (hi - lo + 1L))
chk_hot  <- mean(one$y[(i - W):(i - 1L)])
ok <- isTRUE(all.equal(one$base_excl[i], chk_base)) &&
      isTRUE(all.equal(one$hot[i], chk_hot))
stopifnot(ok)
手計算と一致しました.
主張の再現
fit_hot <- function(d, base_col) {
  x <- d[!is.na(hot) & is.finite(get(base_col)) & pit_bf >= 100]
  x[, base := get(base_col)]
  m <- glm(y ~ hot + base + same_hand + home + yearf + pit_g,
           family = binomial, data = x)
  q <- unname(quantile(x$hot, c(0.1, 0.9)))
  # 調子だけを10分位->90分位に動かしたときの予測出塁率の差
  set.seed(1)
  nd <- x[sample(.N, min(50000, .N))]
  nd[, hot := q[1]]; p1 <- mean(predict(m, nd, type = "response"))
  nd[, hot := q[2]]; p2 <- mean(predict(m, nd, type = "response"))
  list(coef = unname(coef(m)["hot"]), se = coef(summary(m))["hot", 2],
       ci = unname(confint.default(m)["hot", ]), diff = p2 - p1, q = q, n = nrow(x))
}

r_excl <- fit_hot(dat, "base_excl")   # 論文の設計
r_full <- fit_hot(dat, "base_full")   # 窓を除かない設計
論文と同じ設計で当てはめると, 調子の係数は +0.3831 (95%CI [+0.3530, +0.4132]) です.
調子を10分位 (直近25打席で20%出塁) から 90分位 (48%) に動かすと, 予測出塁率は+0.0236上がります.
打者の能力の標準偏差は0.0370なので, これは 0.64標準偏差にあたります. 論文の「0.5〜1標準偏差」がそのまま出ました.
dat[!is.na(hot), .(出塁率 = mean(y), 打席 = .N), by = .(調子 = round(hot, 2))][打席 >= 2000] %>%
  ggplot(aes(x = 調子, y = 出塁率)) +
  geom_point(aes(size = 打席), alpha = 0.5) +
  geom_smooth(method = "lm", se = FALSE) +
  labs(x = paste0("直近", W, "打席の出塁率"), y = "この打席の出塁率",
       title = "調子が良いほど次も出塁している") +
  theme_minimal()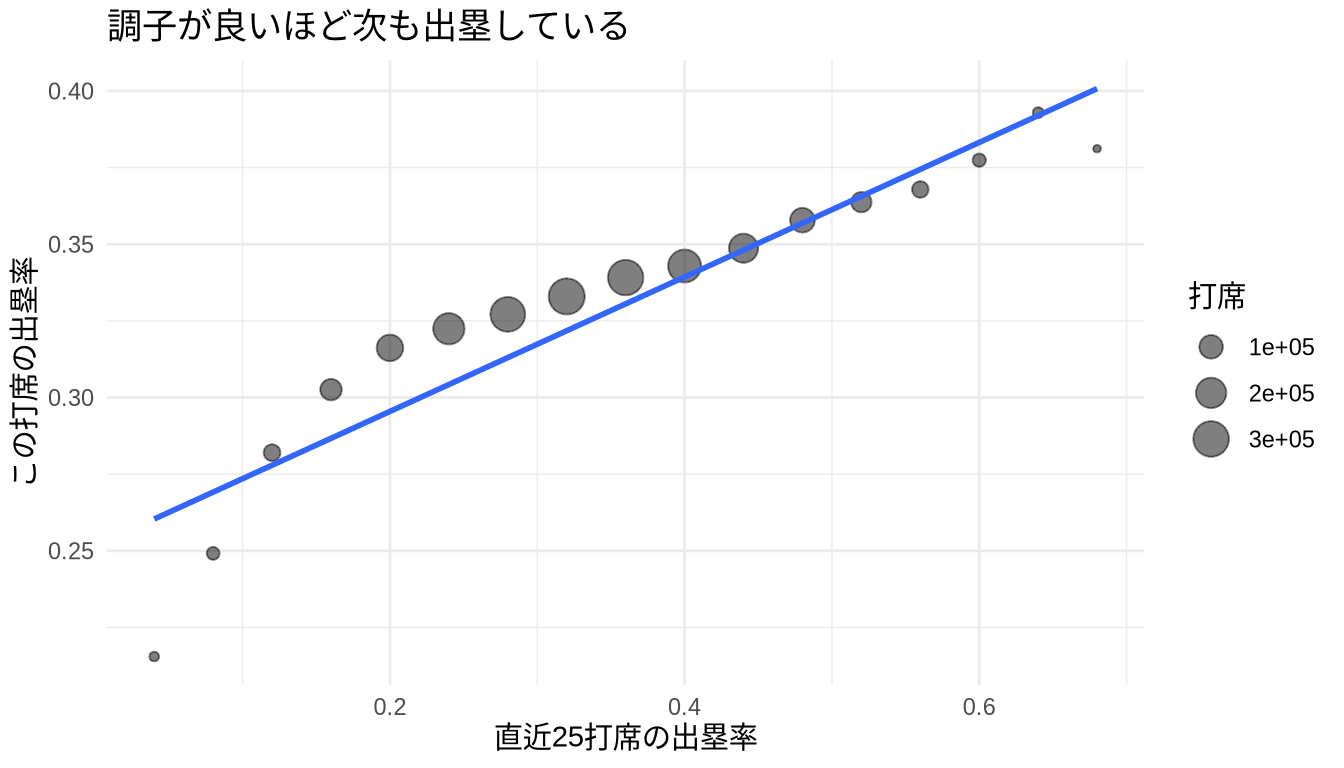
見た目にもはっきりした関係があります. ここで止めれば論文の再現です.
測り方を疑う
論文の基準は「シーズン成績から前後50打席を除いたもの」でした. ここに問題があります.
シーズンの合計は決まっています. ある25打席でたまたま出塁が多ければ, 残りの打席では平均が下がります. 引き算しているので当然です. つまり「調子」と「基準」は, 真の連続性がまったく無くても負に相関します.
確かめます. ただし打者をまたいで相関を取ってはいけません. 良い打者は調子も基準も高いので, 能力差が機械的な負の相関を覆い隠します. 打者シーズンごとに平均を引いてから見ます.
cc <- dat[!is.na(hot) & is.finite(base_excl) & is.finite(base_full) & n_pa >= 300]
cor_all_e <- cc[, cor(hot, base_excl)]
cor_all_f <- cc[, cor(hot, base_full)]
# 打者シーズン内だけの動き (各打者の平均を引く)
cc[, `:=`(h_w  = hot - mean(hot),
          be_w = base_excl - mean(base_excl),
          bf_w = base_full - mean(base_full)), by = .(year, BAT_ID)]
cor_win_e <- cc[, cor(h_w, be_w)]
cor_win_f <- cc[, cor(h_w, bf_w)]| 基準 | 打者をまたいだ相関 | 打者シーズン内の相関 |
|---|---|---|
| 論文の基準 (前後50打席を除く) | +0.242 | -0.665 |
| 窓を除かないシーズン平均 | +0.366 | +0.003 |
打者をまたぐと両方とも正 (良い打者はどちらも高い) ですが, 同じ打者の中で見ると論文の基準は-0.665と強く負に振れます. 窓を除かない基準は+0.003で, ほぼ無相関です.
モデルは基準を統制した上で調子の係数を読みます. 調子が良い打席ほど基準が不当に低く見積もられていれば, その反動が調子の効果として現れます.
並べ替え検定
疑うだけでは足りないので, 測ります. 打者シーズンの中で打席結果を並べ替えます. こうすると真の連続性は完全に消えますが, シーズン合計も打者の能力も変わりません.
真の効果がゼロのデータに同じ手続きを当てて, ゼロが返ってくるかを見ます.
NSIM <- 4L
shuffle_once <- function(k) {
  set.seed(100 + k)
  z <- copy(dat)
  setorder(z, year, BAT_ID, pa_i)
  z[, y := sample(onbase), by = .(year, BAT_ID)]   # 打者シーズン内で並べ替え
  z <- add_streak(z)
  a <- fit_hot(z, "base_excl"); b <- fit_hot(z, "base_full")
  data.table(k = k, excl_coef = a$coef, excl_diff = a$diff,
             full_coef = b$coef, full_diff = b$diff)
}
sim <- rbindlist(lapply(seq_len(NSIM), shuffle_once))| 設計 | 実データの効果 | 並べ替えデータの効果 | 差し引き |
|---|---|---|---|
| 論文の設計 (前後50打席を除く) | +0.0236 | +0.0195 | +0.0041 |
| 窓を除かない基準 | +0.0058 | +0.0009 | +0.0049 |
連続性を壊したデータでも, 論文の設計は+0.0195という効果を返します. 実データで測った+0.0236のうち 83%は, 測り方が作り出したものでした.
窓を除かない基準では, 並べ替えデータの効果は +0.0009とほぼゼロです. この設計にはその歪みがありません.
data.table(
  設計 = rep(c("論文の設計\n(前後50打席を除く)", "窓を除かない基準"), each = 2),
  データ = rep(c("実データ", "並べ替え"), 2),
  効果 = c(r_excl$diff, mean(sim$excl_diff), r_full$diff, mean(sim$full_diff))) %>%
  ggplot(aes(x = 設計, y = 効果, fill = データ)) +
  geom_col(position = "dodge") +
  geom_hline(yintercept = 0) +
  labs(y = "調子10分位->90分位での出塁率の差", x = NULL,
       title = "並べ替えても消えない分が, 測り方による見かけの効果") +
  theme_minimal()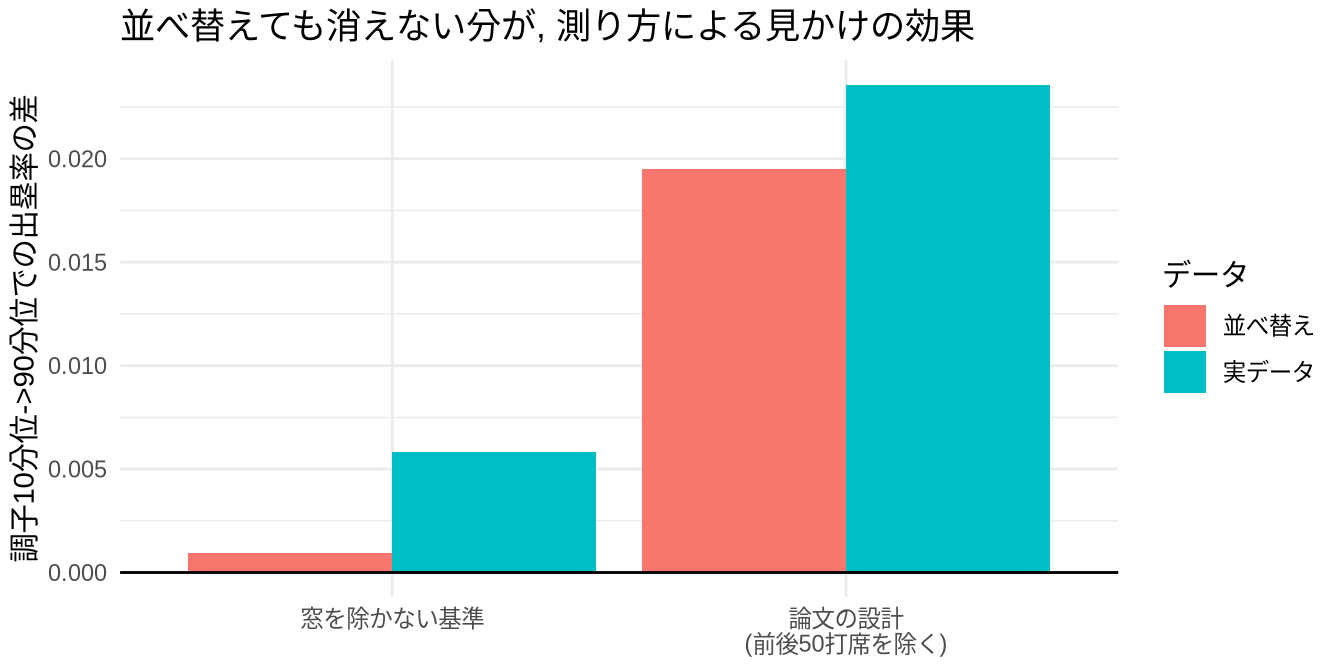
差し引いて残るもの
2つの設計から機械的な分を差し引くと, +0.0041 と +0.0049 になります. 別々の設計が近い値に落ち着きました.
これは打者の能力の0.13標準偏差ぶんです. 論文の「0.5〜1標準偏差」の6分の1程度にあたります.
並べ替え4回のばらつきは 0.00090なので, この残りは誤差では説明できません. ホットハンドは実在するが, 論文が言うほど大きくないというのが結論です.
一番弱いベースラインと比べる
「全打席に同じ確率 (全体の出塁率) を答える」より当たるのか確かめます.
ev <- dat[!is.na(hot) & is.finite(base_full) & pit_bf >= 100]
m_base  <- glm(y ~ 1, family = binomial, data = ev)
m_skill <- glm(y ~ base_full + same_hand + home + yearf + pit_g,
               family = binomial, data = ev)
m_hot   <- glm(y ~ hot + base_full + same_hand + home + yearf + pit_g,
               family = binomial, data = ev)
logloss <- function(m) {
  p <- fitted(m); -mean(ev$y * log(p) + (1 - ev$y) * log(1 - p))
}| 予測 | 対数損失 |
|---|---|
| 全打席に同じ確率 (ベースライン) | 0.635594 |
| 能力と状況のみ | 0.630030 |
| 能力と状況 + 調子 | 0.630022 |
調子を足しても対数損失は8.5e-06しか改善しません. 能力と状況を入れた時点での改善0.0056と比べても小さい. 打席単位の予測としては, ほとんど役に立ちません.
追試のまとめ
| 論文の主張 | 手元の結果 | 判定 |
|---|---|---|
| 打席単位でホットハンドが検出できる | 検出できる (係数 +0.3831, 95%CI [+0.3530, +0.4132]) | 再現した |
| 効果は打者の能力の0.5〜1標準偏差 | 論文の設計では 0.64 SD, 機械的な分を引くと 0.13 SD | 再現できない |
| 測り方 (前後50打席を除く基準) は妥当 | 連続性を壊したデータでも 83% の効果が出る | 問題あり |
存在は再現し, 大きさは再現できませんでした.
論文が観測したものの大半は, 「シーズン成績から当該窓を引く」という 基準の作り方が生む見かけの効果です. 同じ批判は Lichtman (2016) が指摘していましたが, ここでは並べ替え検定でその大きさを直接測りました.
ホットハンド自体は残ります. ただし 0.13標準偏差は, 打席単位の予測を改善するには小さすぎる量です.
関連記事
- 連続安打はランダムと区別できるか (Albright 1993 の追試) — 正反対の結論を出した論文の追試. 2本が矛盾しない理由をそちらで説明しています
- デッドボールは報復なのか (Bradbury & Drinen 2007 の追試)
注意
- 結果は出塁 (安打・四球・死球) です. 論文は10の指標を調べており, ここで再現したのはそのうちの1つです. 本塁打や三振では違う可能性があります.
- 並べ替えは打者シーズン内で行いました. 相手投手や球場との対応が崩れるので, 「真の連続性だけを消す」以上のものを壊しています. ただし壊れた対応は統制変数に入っているので, 調子の係数への影響は小さいはずです.
- 「調子」は直近25打席です. 論文と同じ長さですが, この長さ自体に根拠があるわけではありません.
- 怪我や起用法は見ていません. 不調な打者は途中で外されるので, 観測される連続性は実際より小さく出ているはずです.
- 対象は2000-2011年で, 論文と同じ期間です. 手元のデータは2011年より後を含みません.