消えた選手を数に入れる
2026-08-12
前の記事の積み残し
年齢曲線の記事では, 同じ選手の前年との差だけを積み上げて 加齢の効果を出しました. 最後にこう書いています.
この曲線も生存バイアスから完全には自由ではありません. 前年との差を取るには 「2年続けて300打席立つ」必要があり, 大きく崩れた打者は差を作れずに消えます.
ここを詰めます. 消えた選手を欠測として扱い, 埋めてから曲線を引き直すとどうなるか.
library(Lahman)
library(dplyr)
library(ggplot2)

SINCE <- 1970    # DH 導入以降
QUAL  <- 300     # 「その年の主力」とみなす打席数
OBS   <- 50      # これだけ立っていれば成績は観測できたとみなす
AGES  <- 21:39
M     <- 20      # 代入の回数
B     <- 30      # 代入1回あたりの再標本化の回数
season <- Batting %>%
filter(yearID >= SINCE) %>%
group_by(playerID, yearID) %>%
dplyr::summarise(across(c(AB, H, X2B, X3B, HR, BB, HBP, SF, SH),
~ sum(.x, na.rm = TRUE)), .groups = "drop") %>%
mutate(PA = AB + BB + HBP + SF + SH,
OBP = (H + BB + HBP) / (AB + BB + HBP + SF),
SLG = (H + X2B + 2*X3B + 3*HR) / AB,
OPS = OBP + SLG) %>%
filter(AB > 0) %>%
inner_join(People %>% dplyr::select(playerID, birthYear, birthMonth), by = "playerID") %>%
filter(!is.na(birthYear), !is.na(birthMonth)) %>%
mutate(age = yearID - birthYear - (birthMonth > 6))
lgm <- season %>% filter(PA >= QUAL) %>%
group_by(yearID) %>% dplyr::summarise(m = mean(OPS), .groups = "drop")
season <- season %>% inner_join(lgm, by = "yearID") %>% mutate(rel = OPS - m)rel は「その年の主力打者の平均から OPS
が何ポイント離れているか」です. 時代の水準を消すためで,
前の記事と同じ作りです.
career <- season %>% arrange(playerID, yearID) %>%
  group_by(playerID) %>% mutate(exp = row_number() - 1) %>%
  ungroup() %>% dplyr::select(playerID, yearID, exp)

nxt <- season %>% transmute(playerID, yearID = yearID - 1, PA_n = PA, rel_n = rel)

pairs <- season %>% filter(PA >= QUAL) %>%
  left_join(nxt,    by = c("playerID", "yearID")) %>%
  left_join(career, by = c("playerID", "yearID")) %>%
  mutate(PA_n = ifelse(is.na(PA_n), 0, PA_n)) %>%
  filter(age %in% AGES[-length(AGES)]) %>%
  mutate(状態 = case_when(PA_n >= QUAL ~ "翌年も規定到達",
                          PA_n >= OBS  ~ "翌年は出場のみ",
                          TRUE         ~ "翌年は消える"),
         obs = PA_n >= OBS)
誰が消えるのか
300打席立った選手year 13,615件の, 翌年の行き先です.
| 状態 | 人数 | その年の rel | 平均年齢 |
|---|---|---|---|
| 翌年も規定到達 | 9904 | 0.015 | 28.218 |
| 翌年は出場のみ | 2488 | -0.042 | 28.968 |
| 翌年は消える | 1223 | -0.038 | 29.345 |
翌年も規定打席に届いた選手だけが, 前の記事の材料でした. 2,488件は出場はしたが規定に届かず, 1,223件は完全に消えます.
消える側はその年の成績が悪い. 偶然ではありません.
q5 <- pairs %>% mutate(層 = ntile(rel, 5)) %>%
  group_by(層) %>%
  dplyr::summarise(rel = mean(rel), 消失率 = mean(状態 == "翌年は消える"),
                   .groups = "drop")

ggplot(q5, aes(x = factor(層), y = 消失率)) +
  geom_col() +
  xlab("その年の成績による5分位 (1が下位)") + ylab("翌年に消える割合") +
  ggtitle("成績が悪い選手ほど翌年に消える")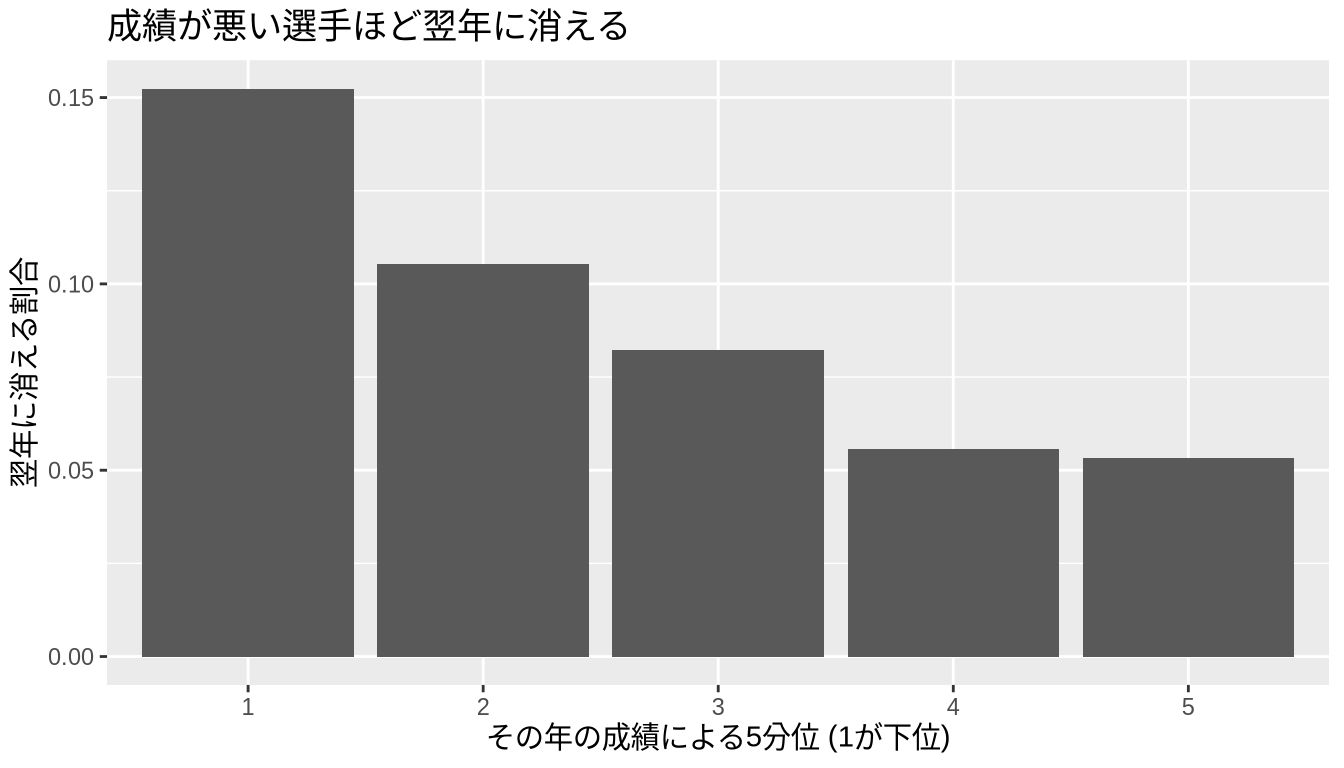
下位5分の1は15.2%が消え, 上位5分の1は5.3%です. 欠測は成績と結びついています. 無作為に欠けているのではないので, 「あるものだけで計算する」は使えません.
byage <- pairs %>% group_by(age) %>%
  dplyr::summarise(消える = mean(状態 == "翌年は消える"),
                   出場のみ = mean(状態 == "翌年は出場のみ"), n = n(), .groups="drop") %>%
  filter(n >= 50)

byage %>% tidyr::pivot_longer(c(消える, 出場のみ), names_to = "行き先", values_to = "割合") %>%
  ggplot(aes(x = age, y = 割合, colour = 行き先)) +
  geom_line() + geom_point(size = 1) +
  xlab("年齢") + ylab("割合") +
  ggtitle("高齢になるほど翌年に消える")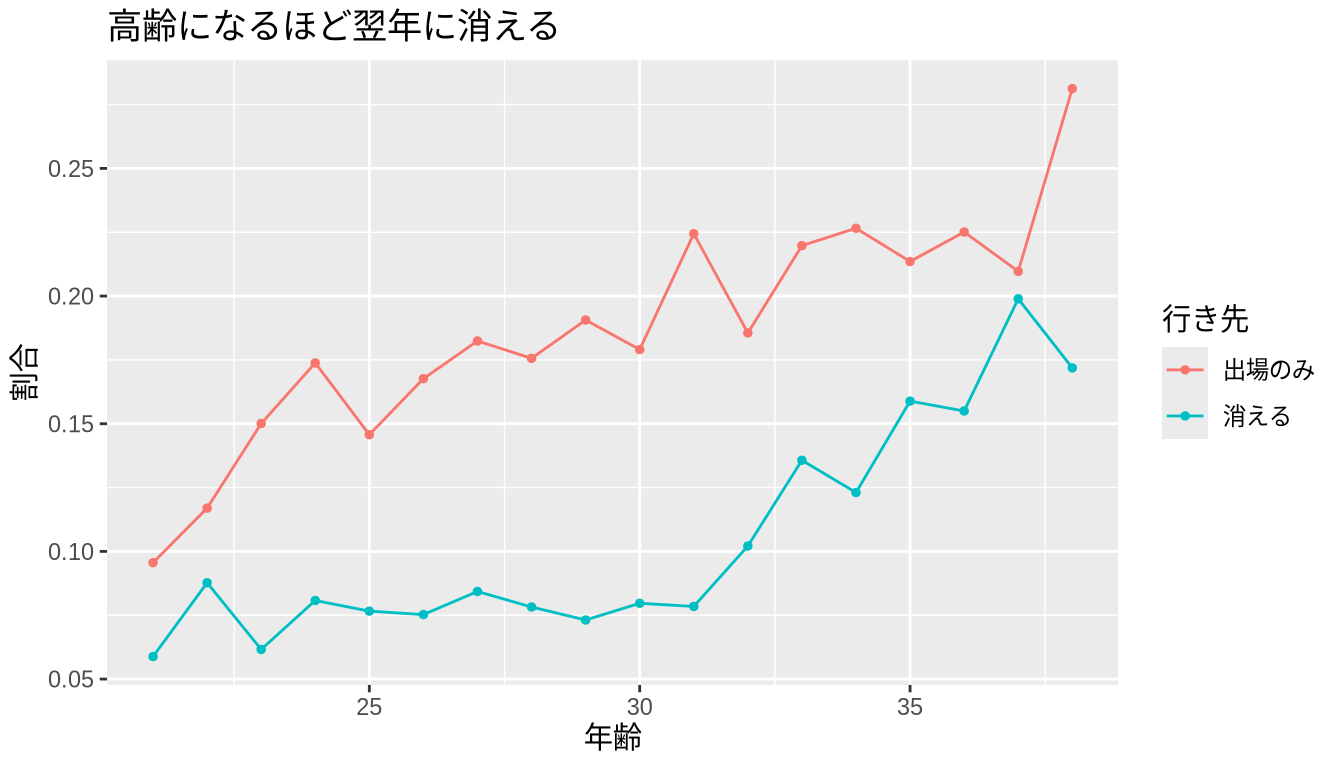
まず, 捨てていた観測を拾う
埋める前にやることがあります. 2,488件の「出場はした」選手は, 欠測ではありません. 打席数は少ないながら成績は観測できています. 規定打席で切ったせいで捨てていただけです.
chain <- function(d) {
  s <- d %>% group_by(age) %>%
    dplyr::summarise(delta = weighted.mean(rel_n - rel, PA), .groups = "drop") %>%
    arrange(age)
  data.frame(age = c(s$age, max(s$age) + 1), rel = c(0, cumsum(s$delta)))
}
peak_of <- function(cv) cv$age[which.max(cv$rel)]
drop_of <- function(cv) {
  v <- cv$rel[cv$age == 34]
  if (!length(v)) return(NA_real_)      # 再標本化で34歳が消えることがある
  max(cv$rel) - v
}

naive <- chain(pairs %>% filter(状態 == "翌年も規定到達"))
ext   <- chain(pairs %>% filter(obs))
ピークから34歳までの落ち幅は, 規定到達だけだと0.113, 出場のみの選手も入れると0.202です. モデルを何も使わずに, 衰えの見積もりが1.8倍になりました.
一番大きな補正は, 統計手法ではなく観測を捨てないことから来ます.
消えた選手を埋める
残るは1,223件です. こちらは本当に観測がありません. 翌年の
rel を, 観測できた選手から作った回帰で埋めます.
1回埋めて終わりにはできません. 埋めた値は推定なので, その不確かさを 結果に反映させる必要があります. 回帰係数と残差分散を事後分布から引き直しながら 20回埋め, 20本の曲線を作ります (多重代入).
impute_once <- function(d, shift = 0) {
  o <- d[d$obs, ]; mi <- d[!d$obs, ]
  if (!nrow(mi)) return(o)
  f  <- ~ rel + age + I(age^2) + log(PA) + exp
  X  <- model.matrix(f, o); Xm <- model.matrix(f, mi); y <- o$rel_n
  XtXi <- solve(crossprod(X))
  bhat <- XtXi %*% crossprod(X, y)
  s2   <- sum((y - X %*% bhat)^2) / rchisq(1, nrow(X) - ncol(X))  # 分散を事後から引く
  bst  <- bhat + t(chol(s2 * XtXi)) %*% rnorm(ncol(X))            # 係数を事後から引く
  mi$rel_n <- as.vector(Xm %*% bst) + rnorm(nrow(mi), 0, sqrt(s2)) + shift
  rbind(o, mi)
}
set.seed(1)
pd <- as.data.frame(pairs)
mi_curves <- vector("list", M); Q <- numeric(M); U <- numeric(M)
for (m in 1:M) {
im <- impute_once(pd) # 行の順序は pd と違うので添字は毎回作り直す
cv <- chain(im); mi_curves[[m]] <- cv; Q[m] <- drop_of(cv)
# 代入内のばらつきは選手単位の再標本化で見る (同じ選手の全行をまとめて抜き差しする)
idx <- split(seq_len(nrow(im)), im$playerID)
bs <- replicate(B, {
s <- sample(names(idx), length(idx), replace = TRUE)
drop_of(chain(im[unlist(idx[s], use.names = FALSE), ]))
})
U[m] <- var(bs, na.rm = TRUE)
}Rubin の規則でまとめます. 代入内の分散の平均に, 代入間の分散を足します.
Qbar <- mean(Q); Ubar <- mean(U); Bvar <- var(Q)
Tvar <- Ubar + (1 + 1/M) * Bvar
ci <- Qbar + c(-1.96, 1.96) * sqrt(Tvar)| 方法 | ピーク | 34歳までの落ち |
|---|---|---|
| 規定到達のみ (前の記事) | 25 | 0.113 |
| 出場のみも入れる | 23 | 0.202 |
| 多重代入で消えた選手も埋める | 23 | 0.195 |
多重代入まで含めた落ち幅は0.195 (95%区間 0.179 〜 0.211) です. 代入間の分散は全体の15%を占めます.
cmp <- rbind(
  transform(naive,    rel = rel - max(rel), 方法 = "規定到達のみ"),
  transform(ext,      rel = rel - max(rel), 方法 = "出場のみも入れる"),
  transform(mi_curve, rel = rel - max(rel), 方法 = "多重代入"))

ggplot(cmp, aes(x = age, y = rel, colour = 方法)) +
  geom_line() + geom_point(size = 1) +
  xlab("年齢") + ylab("ピークからの OPS 差") +
  ggtitle("消えた選手をどう扱うかで曲線が変わる")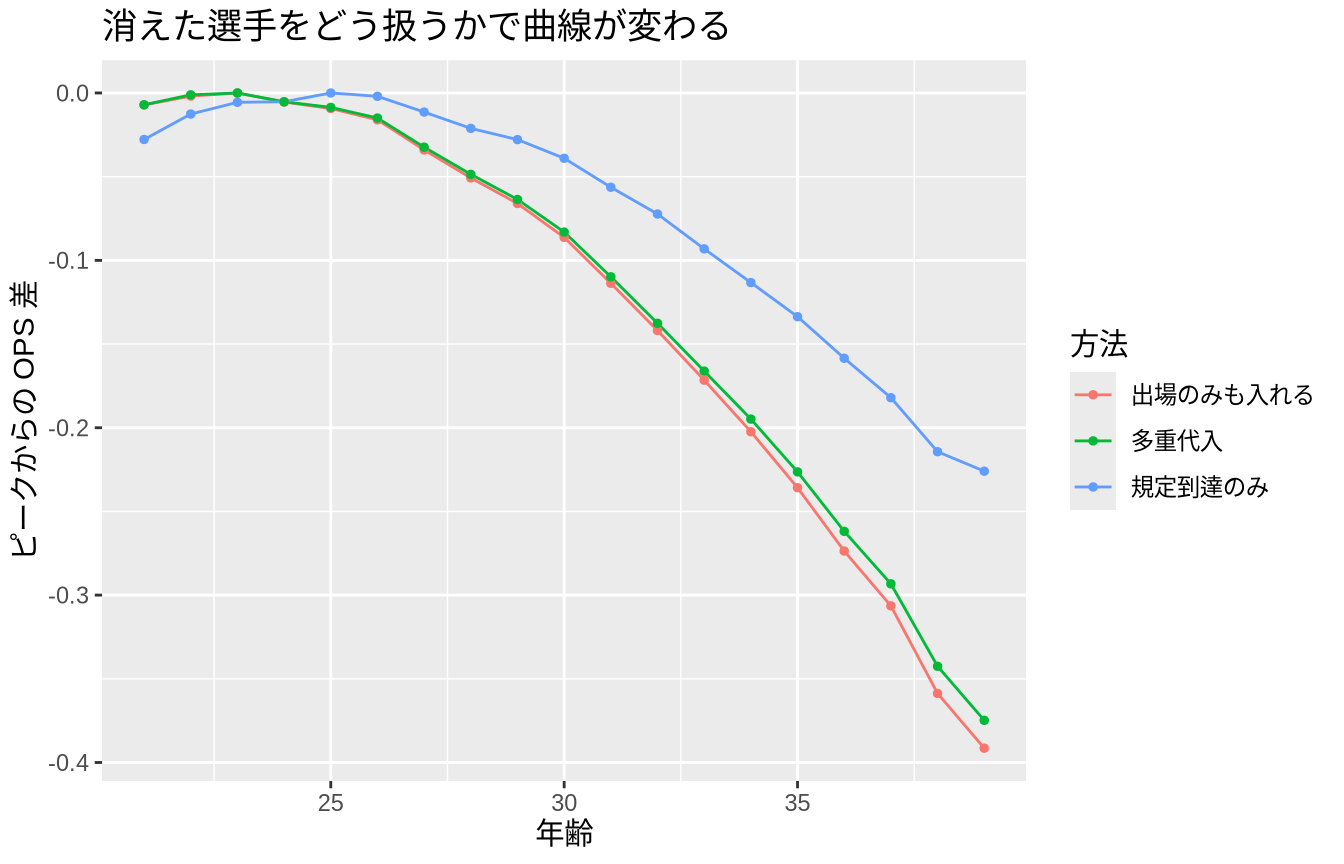
1,223件を埋めた効果は, 出場のみの選手を入れた効果より ずっと小さいです. 埋めた値は回帰による予測なので, 平均のほうへ寄ります. 消えた選手が「平均的な予測どおり」だったのなら, これで正しい.
消えた選手は予測より悪かったのではないか
そこが問題です. 選手が消えるのは, これから落ちるからです. 多重代入は 「観測できた変数が同じなら, 消えた選手も残った選手と同じように振る舞う」 という仮定 (MAR) を置いていますが, 現実には観測できなかった翌年の成績そのものが 消える理由になっています.
仮定を検証することはできません. 代わりに, どれだけ外れていたら結論が変わるかを見ます. 埋めた値を一律に下へずらしてやり直します.
set.seed(2)
sens <- do.call(rbind, lapply(c(0, -0.02, -0.05, -0.10), function(sh) {
  cs <- lapply(1:10, function(i) chain(impute_once(pd, sh)))
  cv <- data.frame(age = cs[[1]]$age, rel = rowMeans(sapply(cs, function(c) c$rel)))
  data.frame(ずらし幅 = sh, ピーク = peak_of(cv), `34歳までの落ち` = drop_of(cv),
             check.names = FALSE)
}))| ずらし幅 | ピーク | 34歳までの落ち |
|---|---|---|
| 0.00 | 23 | 0.194 |
| -0.02 | 22 | 0.212 |
| -0.05 | 22 | 0.239 |
| -0.10 | 21 | 0.284 |
消えた選手が予測より OPS で 0.10 悪かったとすると, 落ち幅は0.284 まで広がります. どこまで悪かったかは, データからは分かりません. 分かるのは「その仮定を置くとここまで動く」ということだけです.
埋めれば正しくなるのか
多重代入が本当に効くのかを, 答えの分かっている疑似データで確かめます. 真の年齢曲線を決め, そこから選手を生成し, 脱落させてから両方の方法を当てます.
true_f <- function(a) -0.0009 * (a - 27)^2
truth  <- data.frame(age = AGES, rel = true_f(AGES) - true_f(min(AGES)))

sim_once <- function(mnar, n = 900) {
  debut <- sample(21:25, n, TRUE); skill <- rnorm(n, 0, 0.06)
  rows <- do.call(rbind, lapply(seq_len(n), function(i) {
    a <- debut[i]:39
    data.frame(playerID = i, age = a, exp = seq_along(a) - 1,
               PA = round(runif(length(a), 300, 650)),
               r = skill[i] + true_f(a) + rnorm(length(a), 0, 0.05))
  }))
  rows <- rows %>% group_by(playerID) %>% mutate(rel = r, rel_n = lead(r)) %>%
    ungroup() %>% filter(!is.na(rel_n)) %>% as.data.frame()
  # 脱落: 今年の成績で決まる部分 + 来年の成績 (観測できない) で決まる部分
  lp <- -2.6 - 5*rows$rel + 0.06*(rows$age - 27) + mnar * (-5 * rows$rel_n)
  rows$obs <- runif(nrow(rows)) > plogis(lp)
  nv <- chain(rows[rows$obs, ])
  mc <- lapply(1:8, function(i) chain(impute_once(rows)))
  mc <- data.frame(age = mc[[1]]$age, rel = rowMeans(sapply(mc, function(c) c$rel)))
  c(脱落率 = mean(!rows$obs), naive = drop_of(nv), mi = drop_of(mc))
}
set.seed(3)
sim <- do.call(rbind, lapply(c(0, 1), function(mn) {
r <- replicate(12, sim_once(mn))
data.frame(脱落の決まり方 = ifelse(mn == 0, "今年の成績だけ (MAR)",
"来年の成績にも依存 (MNAR)"),
脱落率 = mean(r["脱落率", ]),
`真の落ち` = drop_of(truth),
`捨てる場合` = mean(r["naive", ]),
`多重代入` = mean(r["mi", ]), check.names = FALSE)
}))| 脱落の決まり方 | 脱落率 | 真の落ち | 捨てる場合 | 多重代入 |
|---|---|---|---|---|
| 今年の成績だけ (MAR) | 0.1089 | 0.0441 | 0.0536 | 0.0456 |
| 来年の成績にも依存 (MNAR) | 0.1469 | 0.0441 | 0.0449 | 0.0305 |
脱落が観測できる変数だけで決まるなら (MAR), 多重代入は真の値を当てます. 捨てる場合はずれますが, 埋めると戻ります.
脱落が観測できない翌年の成績にも依存すると (MNAR), 多重代入は当たりません. それどころか, 捨てた場合より真の値から離れることがあります. 埋めるという操作は, 「観測できたものから予測できる」という前提の上でしか働きません.
現実の脱落は後者に近いはずです. この記事の0.195という値も, 真の衰えより小さい可能性が高いと考えてください.
結論
- 規定打席で切った年齢曲線は, 衰えを1.8分の1程度に 見せます. 一番大きな補正は打席数の少ない観測を捨てないことで得られます
- 完全に消えた選手を多重代入で埋めても, 変化は小さい. 埋めた値が平均に寄るためです
- 消えた選手が予測より悪かったと仮定すると, 落ち幅はさらに広がります. どこまで悪かったかはデータから決められません
- 疑似データで確かめると, 多重代入が効くのは脱落が観測できる変数で説明できる場合だけです
注意
- 打席数の少ない年の
relはばらつきます. 50打席の OPS は 600打席の OPS ほど信用できません. 重みはその年の打席数だけで付けており, 翌年の打席数は見ていません. - 埋めているのは翌年の成績だけです. その次の年以降は追っていないので, 引退までの軌跡を再現しているわけではありません.
- 代入モデルは線形回帰で, 予測子は前年成績・年齢・打席数・経験年数です. 守備位置や故障は入っていません.
- 疑似データの脱落モデルは実際の脱落率 (9.0%) に 合わせてありますが, 形そのものは仮定です.
- 前の記事と同じく,
relは OPS を同年の主力の平均と比べたものです. 平均を作る集団が年ごとに違うので, 完全な時代補正ではありません.
関連
- 打者は何歳でピークを迎えるか — この記事の前提になる曲線
- キャリアはどれくらい続くか — 消えること自体を対象にした話
- 去年3割打った選手は今年も打てるのか — 同じ選抜の問題を予測で扱う