去年3割打った選手は今年も打てるのか
2026-08-11
予測の問題として立てる
「去年3割打ったから今年も打つだろう」は自然な推論です. これを予測問題として書き, どれくらい当たるのかを測ります.
あるシーズンを丸ごと隠し, それ以前だけを使って隠したシーズンの打率を当てる. 隠すシーズンは最初に決めて動かしません. 結果を見てから選び直すと, 何を測ったのか 分からなくなります.
library(Lahman)
library(dplyr)
library(ggplot2)

HOLDOUT      <- 2025    # 隠すシーズン (Lahman 14.0.0 に入っている最後の年)
TRAIN_FROM   <- 2021    # 学習に使う最初の年
MIN_AB_MODEL <- 250     # 階層モデルに入れる打数
MIN_AB_TEST  <- 200     # 予測の的にする打数
的にする側の打数を200以上に絞るのは, 当てにいく値そのものが ばらつくのを避けるためです. 50打数の打率は予測の巧拙と関係なく揺れます.
2020年は60試合制で打数がまったく違うので, 学習期間には入れていません.
season <- Batting %>%
  filter(yearID >= TRAIN_FROM, yearID <= HOLDOUT) %>%
  group_by(playerID, yearID) %>%       # 移籍した年は stint が分かれるので合算する
  dplyr::summarise(AB = sum(AB, na.rm = TRUE), H = sum(H, na.rm = TRUE),
                   .groups = "drop") %>%
  filter(AB > 0) %>%
  inner_join(People %>% dplyr::select(playerID, birthYear, birthMonth),
             by = "playerID") %>%
  filter(!is.na(birthYear), !is.na(birthMonth)) %>%
  mutate(age = yearID - birthYear - (birthMonth > 6))
年齢は「そのシーズンの6月30日時点で何歳か」とします. 年齢曲線の記事と同じ定義です. 守備位置は, 学習期間に一番多く出た場所で決めます.
pos <- Appearances %>%
  filter(yearID >= TRAIN_FROM, yearID < HOLDOUT) %>%
  group_by(playerID) %>%
  dplyr::summarise(C = sum(G_c), IF = sum(G_1b + G_2b + G_3b + G_ss),
                   OF = sum(G_of), DH = sum(G_dh), .groups = "drop") %>%
  mutate(pos = c("C", "IF", "OF", "DH")[max.col(across(c(C, IF, OF, DH)))]) %>%
  dplyr::select(playerID, pos)

past  <- season %>% filter(yearID <  HOLDOUT)                     # 学習に使える全記録
model <- past %>% filter(AB >= MIN_AB_MODEL) %>% inner_join(pos, by = "playerID")

test <- season %>% filter(yearID == HOLDOUT, AB >= MIN_AB_TEST) %>%
  inner_join(pos, by = "playerID") %>%
  filter(playerID %in% model$playerID) %>%     # 学習期間に実績のある選手だけ
  mutate(avg = H / AB)
階層モデルの学習データは2021-2024年の1,186人年 (506人), 予測の的は2025年の256人です. 2025年が初めての実働シーズンになる選手は, 過去が無いので対象外です.
一番弱いベースラインを先に置く
比べる相手が無いと, 予測が当たっているのかどうか言えません. 一番弱い相手は 全員に同じ値を答えることです. ここでは学習期間のリーグ全体の打率を使います.
lg <- sum(past$H) / sum(past$AB)これを下回れないなら, その予測は何もしていないのと同じです.
前年の打率をそのまま使う
素直な予測を2つ並べます. どちらもベースラインが不利にならないよう, 打数の制限をかけずにその選手の全記録から作ります.
- 前年: 2024年の打率をそのまま答える
- キャリア: 2021-2024年の通算打率を答える
prev <- past %>% filter(yearID == HOLDOUT - 1) %>%
  transmute(playerID, prev = H / AB)

career <- past %>% group_by(playerID) %>%
  dplyr::summarise(cH = sum(H), cAB = sum(AB), career = cH / cAB, .groups = "drop")

pred <- test %>%
  left_join(prev,   by = "playerID") %>%
  left_join(career, by = "playerID") %>%
  mutate(リーグ平均 = lg,
         前年       = ifelse(is.na(prev), lg, prev),
         キャリア   = career)
rmse <- function(p, a) sqrt(mean((p - a)^2))
mae <- function(p, a) mean(abs(p - a))
score <- function(d, cols) {
data.frame(方法 = cols,
RMSE = sapply(cols, function(k) rmse(d[[k]], d$avg)),
MAE = sapply(cols, function(k) mae(d[[k]], d$avg)),
row.names = NULL)
}
s1 <- score(pred, c("リーグ平均", "前年", "キャリア"))| 方法 | RMSE | MAE |
|---|---|---|
| リーグ平均 | 0.0270 | 0.0216 |
| 前年 | 0.0313 | 0.0241 |
| キャリア | 0.0265 | 0.0211 |
前年の打率をそのまま使うと, 全員にリーグ平均を答えるより悪くなります (RMSE 0.0313 対 0.0270).
「去年3割打った選手は今年も打てるのか」への答えは, 少なくともこの形では 「去年の数字を持ってくるくらいなら, 全員に平均を答えたほうがまし」です.
なぜ負けるのか
前年の打率には, 実力と「その年たまたま」が混ざっています. 予測に使えるのは 実力の部分だけなのに, そのまま持ってくると偶然の分まで来年に持ち越してしまいます.
前年の成績で選手を5つに分け, 2025年に何が起きたかを見ます.
reg <- pred %>% filter(!is.na(prev)) %>%
  mutate(層 = ntile(prev, 5)) %>%
  group_by(層) %>%
  dplyr::summarise(前年 = mean(prev), 翌年 = mean(avg), n = n(), .groups = "drop")

reg %>%
  tidyr::pivot_longer(c(前年, 翌年), names_to = "年", values_to = "打率") %>%
  ggplot(aes(x = factor(層), y = 打率, colour = 年, group = 年)) +
  geom_line() + geom_point(size = 2) +
  geom_hline(yintercept = lg, linetype = "dashed") +
  xlab(paste0("前年 (", HOLDOUT - 1, "年) の打率による5分位")) + ylab("打率") +
  ggtitle("上位も下位も, 翌年は平均に寄る (破線はリーグ平均)")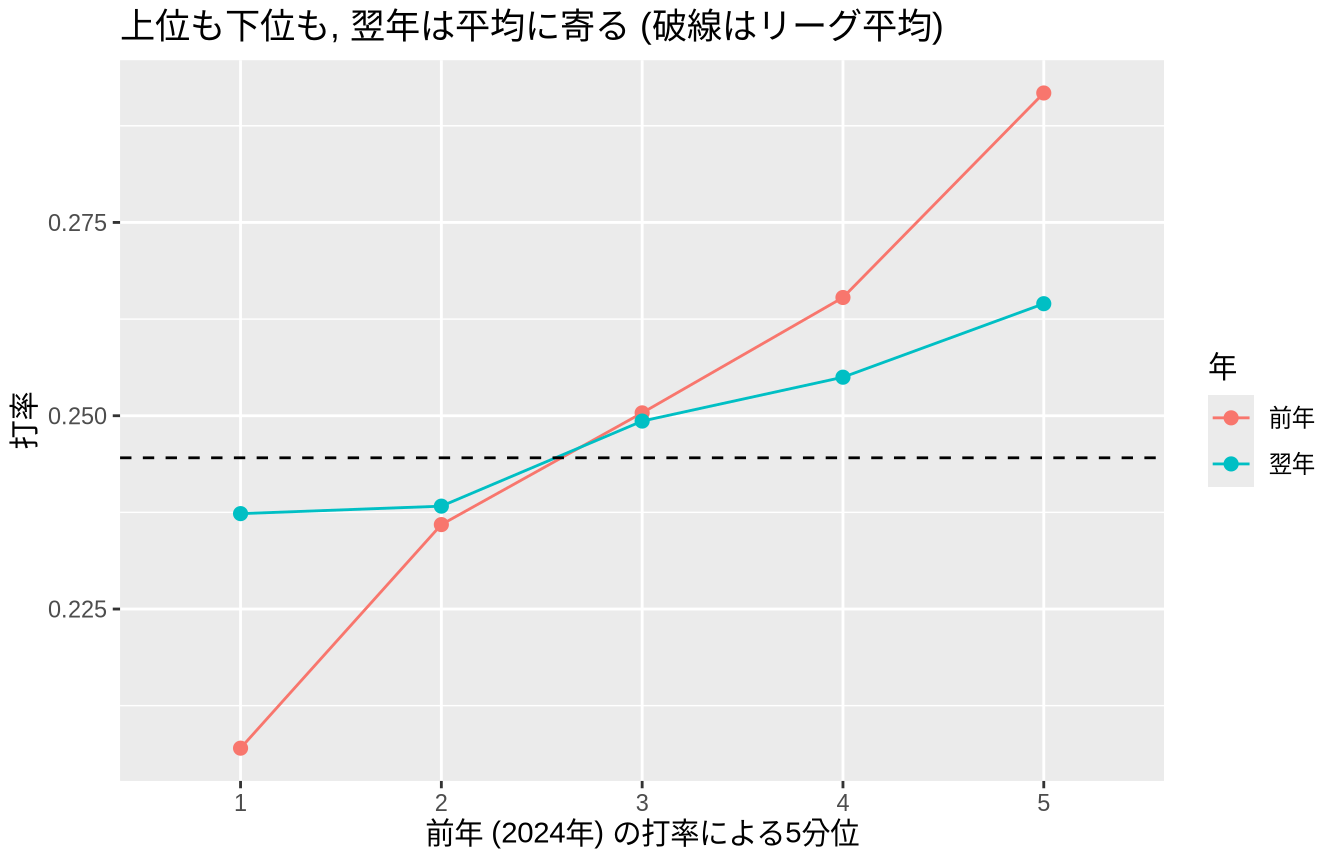
前年の上位5分の1は平均0.292でしたが, 2025年は0.264まで落ちます. 下位5分の1は0.207から0.237へ上がります. 両側から中央に寄る, 平均への回帰です.
前年の値をそのまま使う予測は, この寄りをまったく織り込みません. だから外れます.
平均に寄せる (経験ベイズ)
寄るのが分かっているなら, 最初から寄せておけばよい, というのが縮小推定です. 打率をベータ二項モデルで見て, 通算成績を全体の分布に寄せます.
mm <- career %>% filter(cAB >= 300)
mu <- weighted.mean(mm$career, mm$cAB)
K  <- mu * (1 - mu) / var(mm$career) - 1     # 事前分布の「擬似打数」

pred <- pred %>% mutate(経験ベイズ = (cH + mu * K) / (cAB + K))
K
は事前分布が何打数ぶんの重みを持つかです. ここでは
274打数相当で, 274打数ぶんの
「平均的な打者」を全員の成績に足してから割り直していることになります.
| 方法 | RMSE | MAE |
|---|---|---|
| リーグ平均 | 0.0270 | 0.0216 |
| 前年 | 0.0313 | 0.0241 |
| キャリア | 0.0265 | 0.0211 |
| 経験ベイズ | 0.0246 | 0.0196 |
縮小するとリーグ平均を下回ります (0.0246). 平均に負けない予測を作るのに必要だったのは, 情報を足すことではなく, 持っている情報を信じすぎないことでした.
年齢と守備位置を入れる (階層ベイズ)
経験ベイズは全員を同じ一点に寄せます. 実際には35歳と25歳で寄せ先は違うはずですし, 捕手と指名打者でも違うかもしれません. 寄せ先を共変量で動かします.
選手ごとの打撃力を変量効果, 年齢と守備位置を固定効果にした二項モデルを, 学習期間の人年データに当てます.
library(rstanarm)
options(mc.cores = min(4, parallel::detectCores()))

fit <- stan_glmer(cbind(H, AB - H) ~ poly(age, 2) + pos + (1 | playerID),
                  family = binomial, data = model,
                  chains = 4, iter = 1000, seed = 1, refresh = 0)
250打数以上のシーズンだけを使うのは, 出場機会がごく少ない年を入れると 年齢の効果が「出番が減った年」の効果と混ざるためです.
pred$階層ベイズ <- colMeans(
posterior_epred(fit, newdata = pred %>% dplyr::select(playerID, age, pos)))| 方法 | RMSE | MAE |
|---|---|---|
| リーグ平均 | 0.0270 | 0.0216 |
| 前年 | 0.0313 | 0.0241 |
| キャリア | 0.0265 | 0.0211 |
| 経験ベイズ | 0.0246 | 0.0196 |
| 階層ベイズ | 0.0241 | 0.0188 |
一番当たったのは階層ベイズです. ただし, ここまでの差の付き方には はっきりした落差があります. リーグ平均から経験ベイズへの改善が 0.0023 なのに対し, 経験ベイズから階層ベイズへの改善は 0.0005 しかありません.
効いたのはほとんど「縮小したこと」そのもので, 年齢と守備位置を足したぶんは それに比べれば小さい, というのがこのホールドアウトから言えることです. 共変量を増やすより先に, 手持ちの数字を信じすぎないことのほうが大きく効きます.
年齢の1次の項の事後平均は-0.50 (95%区間 -0.84 〜 -0.14) で, 区間は0を含みません. 4シーズンぶんでも 「歳を取るほど打率は下がる」向きは見えています. それでも予測誤差が ほとんど動かないのは, 年齢で説明できる差が選手間の実力差に比べて小さい ためです. 効果が検出できることと, 予測が良くなることは別です.
縮小はどれくらい効いたのか
予測値そのものの散らばりを見ると, 何が起きたのか分かります.
long <- pred %>%
  tidyr::pivot_longer(c(前年, キャリア, 経験ベイズ, 階層ベイズ),
                      names_to = "方法", values_to = "予測") %>%
  mutate(方法 = factor(方法, levels = c("前年", "キャリア", "経験ベイズ", "階層ベイズ")))

ggplot(long, aes(x = 予測, colour = 方法)) +
  geom_density() +
  geom_vline(xintercept = lg, linetype = "dashed") +
  xlab(paste0(HOLDOUT, "年の打率の予測値")) + ylab("密度") +
  ggtitle("予測値の散らばり (破線はリーグ平均)")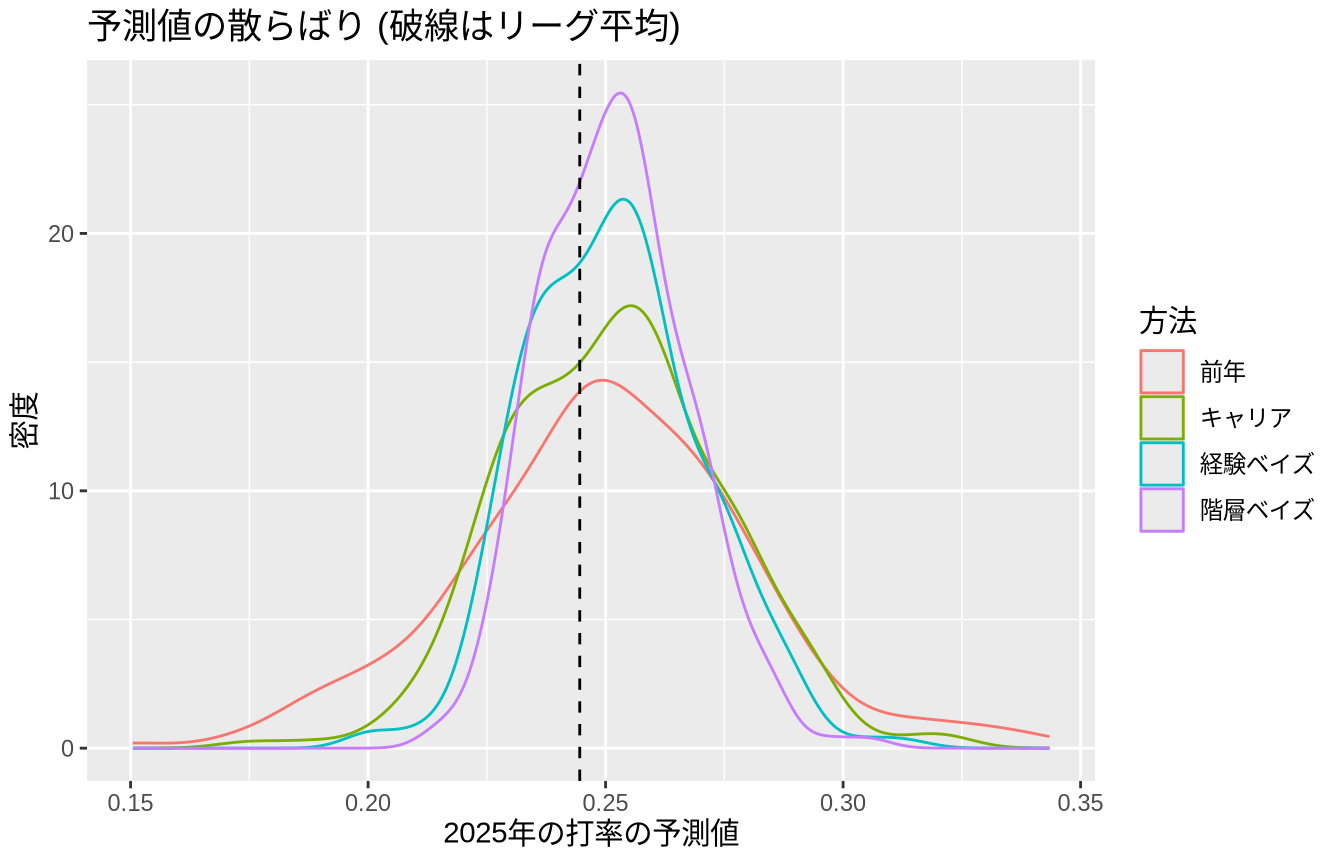
実際の2025年の打率の標準偏差は0.0267です. 予測値の標準偏差は前年が0.0305, 経験ベイズが0.0182, 階層ベイズが0.0151です.
良い予測は実際より散らばりが小さくなります. 予測できるのは実力の差だけで, 来年の偶然は予測できないからです.
前年をそのまま使う予測だけが, 実際の打率より散らばっています (0.0305 対 0.0267). 来年に起きる偶然まで当てにいっている状態で, 順位表としては賑やかですが, 予測としては必ず外れます. RMSE で最下位だったことの中身がこれです.
誰がどれだけ寄せられたのか
打数が少ない選手ほど強く寄せられます.
ggplot(pred, aes(x = cAB, y = 階層ベイズ - career)) +
  geom_point(alpha = 0.5) +
  geom_hline(yintercept = 0, linetype = "dashed") +
  scale_x_log10() +
  xlab("学習期間の通算打数 (対数)") + ylab("階層ベイズ − 通算打率") +
  ggtitle("実績が薄い選手ほど寄せ先に引っぱられる")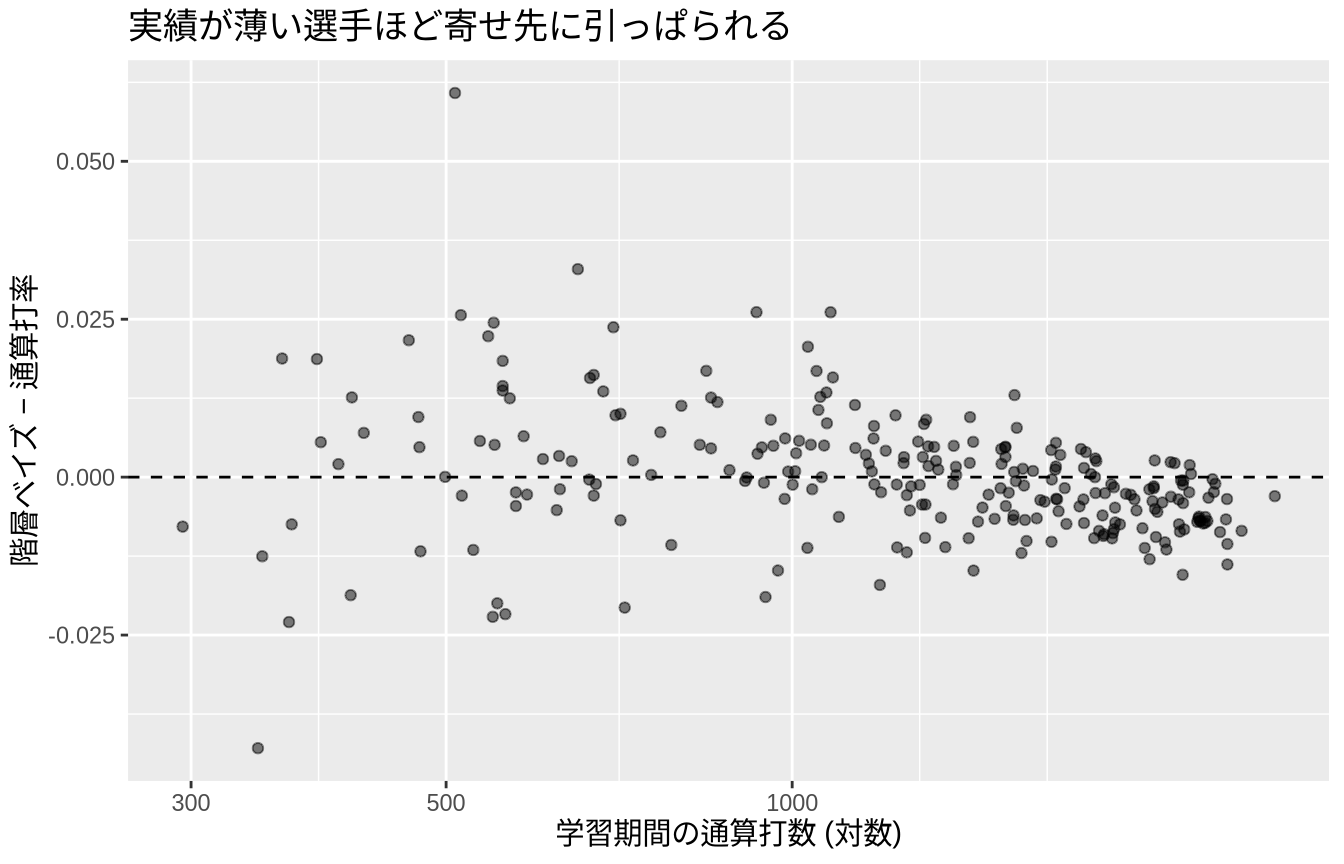
通算打数が下位4分の1の選手では通算打率から平均 0.0121動かされ, 上位4分の1では0.0056しか 動きません. 実績が積み上がっているほど, 自分の数字がそのまま残ります.
注意
- 1シーズンのホールドアウトです. 2025年に固有の事情があれば, 順位はそのぶん動きます. 複数年で繰り返すまでは, 差の大きさより順序を 見てください. とくに経験ベイズと階層ベイズの差は小さく, 年を変えれば 入れ替わりうる程度です.
- 的にしたのは2025年に200打数以上立った選手だけです. 打席に立ち続けられた時点で選抜されています. 大きく崩れて出場機会を失った 選手は評価に入っていないので, どの方法も実際より良く見えているはずです. 年齢曲線の記事と同じ生存バイアスです.
- 学習期間は4シーズンと短く, 年齢の効果を推定するには 一人あたりの追跡が足りません. 加齢そのものを見るなら 年齢曲線の記事のほうが適した設計です.
- 打率だけを見ています. 四球や長打を含めた指標では, 実力の占める割合が変わるので 縮小の効き方も変わります.
- 変量効果は選手の切片だけで, 年齢の効き方は全員共通としています. 実際には 衰えの速さは人によって違います.
- 出場機会 (打数) 自体は予測していません. 打数を所与として打率だけを当てています.
関連
- 打者は何歳でピークを迎えるか — 年齢の効果そのもの
- シーズン序盤の打率から最終打率を当てる — 同じ縮小をシーズン内で行う話