配球に「文法」はあるか
2026-08-17
配球を「並び」として見た記事がありませんでした. ファストボール・カウント はカウント別の頻度までで, 球種がどういう順番で出てくるかは見ていません.
投手の球種の並びはランダムでしょうか. 特定の型が繰り返し現れるでしょうか.
先に結論を書きます. よく出る並びは確かにありますが, そのほとんどは 「打席の中でどの球種を何球投げたか」で説明できます. 同じ球を同じ回数投げたまま 順番だけをシャッフルすると, 並びの頻度はほとんど変わりません.
library(data.table)
library(dplyr)
library(ggplot2)
library(knitr)

source("../../R/sequence.R")
source("../../R/statcast.R")

SEASON <- 2024
src <- sprintf("../../data/statcast_%d_all.csv", SEASON)
if (!file.exists(src)) {
  stop("データがありません: ", src,
       "\n  Rscript data/build-statcast.R ", SEASON, " --all-pitch-types")
}
dat <- fread(src, select = c("game_pk", "at_bat_number", "pitch_number",
                             "pitcher", "player_name", "pitch_type",
                             "events", "delta_run_exp"))
系列の作り方
打席 (PA) を1つの系列とみなします. game_pk ×
at_bat_number で打席が決まり, その中を
pitch_number の順に並べたものが系列です.
配球ではない球を落とします.
# IN (敬遠球) と PO (ウエスト) は打者と勝負していないので配球ではない.
# 残りは出現が数百球以下の珍しい球種で, n-gram の裾を無意味に伸ばす.
DROP <- c("", "IN", "PO", "AB", "UN", "CS", "FO", "SC", "EP", "KN", "FA")
dropped <- dat[pitch_type %in% DROP, .N]

d <- dat[!pitch_type %in% DROP]
setorder(d, game_pk, at_bat_number, pitch_number)
d[, pa := paste(game_pk, at_bat_number)]

n_pitch   <- nrow(d)
n_pa      <- uniqueN(d$pa)
n_pitcher <- uniqueN(d$pitcher)
n_type    <- uniqueN(d$pitch_type)
2024年の投球から5,356球を落として, 706,542球 / 181,963打席 / 812投手が残りました. 球種は10種類です.
d |>
  count(pitch_type, sort = TRUE) |>
  mutate(割合 = n / sum(n)) |>
kable(digits = 3, format.args = list(big.mark = ","))| pitch_type | n | 割合 |
|---|---|---|
| FF | 225,910 | 0.320 |
| SI | 111,897 | 0.158 |
| SL | 104,360 | 0.148 |
| CH | 72,468 | 0.103 |
| FC | 58,206 | 0.082 |
| ST | 51,983 | 0.074 |
| CU | 43,767 | 0.062 |
| FS | 21,898 | 0.031 |
| KC | 12,358 | 0.017 |
| SV | 3,695 | 0.005 |
打席あたりの球数はこうなっています.
pa_len <- d[, .N, by = pa]$Nggplot(data.table(len = pa_len), aes(len)) +
geom_bar(fill = "steelblue") +
scale_x_continuous(breaks = 1:16, limits = c(0, 16)) +
labs(x = "打席あたりの球数", y = "打席数") +
theme_minimal()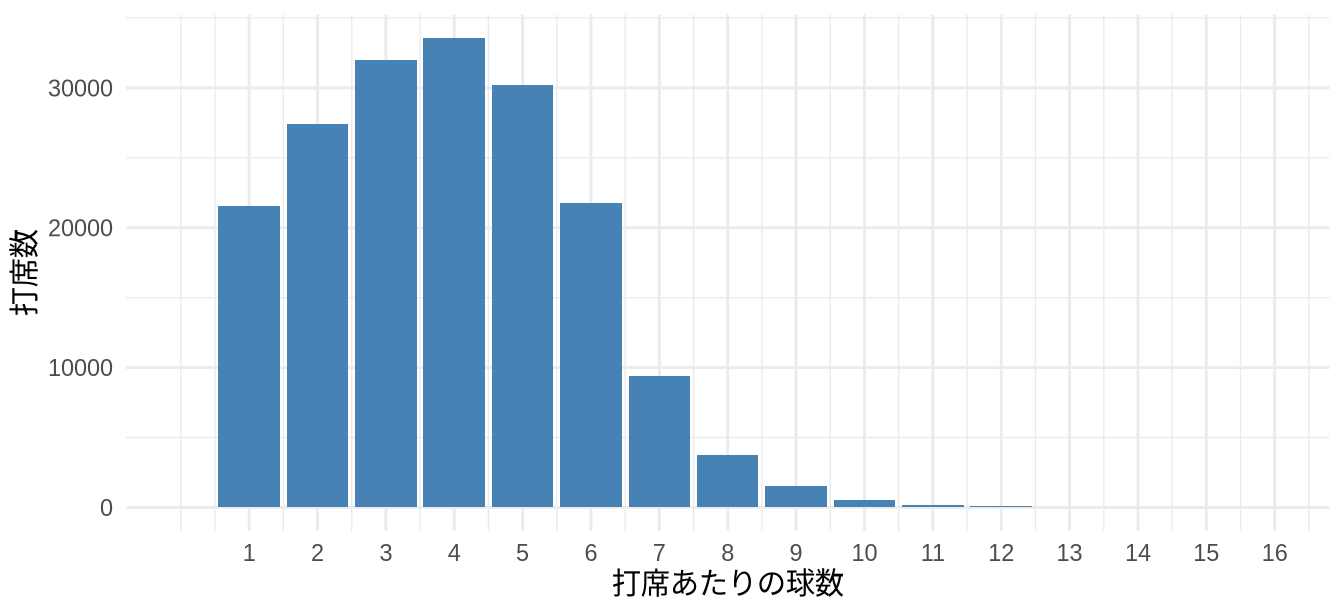
平均3.88球, 中央値4球です. 1球で終わる打席が21,563打席あります. これが後で効いてきます.
n-gram の数え方に1つ罠がある
長さ len の系列から取れる n-gram は
max(0, len - n + 1) 個です. 系列がたくさんあるときの総数は,
これを全部足したものになります.
「総球数 − 打席数 × (n−1)」と書きたくなりますが, これは間違いです. 長さが n に満たない打席は n-gram を1つも出しませんが, この式はそこから (n−1) を引いてしまいます.
naive <- function(len, n) sum(len) - length(len) * (n - 1L)

cmp <- data.table(n = 1:4)
cmp[, 正しい総数 := sapply(n, function(k) ngram_total(pa_len, k))]
cmp[, 素朴な式   := sapply(n, function(k) naive(pa_len, k))]
cmp[, 差         := 正しい総数 - 素朴な式]
kable(cmp, format.args = list(big.mark = ","))| n | 正しい総数 | 素朴な式 | 差 |
|---|---|---|---|
| 1 | 706,542 | 706,542 | 0 |
| 2 | 524,579 | 524,579 | 0 |
| 3 | 364,179 | 342,616 | 21,563 |
| 4 | 231,166 | 160,653 | 70,513 |
n = 2 までは一致します. 長さ1の打席は max(0, 1-1) = 0
で, 式のほうも 1 - 1 = 0 になるからです. n = 3 で
21,563個ずれ, これは1球で終わった打席の数と一致します.
ngram_total() と ngram_counts() は
R/sequence.R に置き, この一致を
tests/testthat/test-sequence.R で検査しています.
よく出る並び
2-gram (2球の並び) を数えます.
g2 <- ngram_counts(d$pitch_type, d$pa, 2L)
stopifnot(sum(g2$N) == ngram_total(pa_len, 2L))

g2 |>
  head(12) |>
  mutate(割合 = N / sum(g2$N)) |>
kable(digits = 4, format.args = list(big.mark = ","))| ngram | N | 割合 |
|---|---|---|
| FF>FF | 73,427 | 0.1400 |
| SI>SI | 29,421 | 0.0561 |
| SL>SL | 28,255 | 0.0539 |
| FF>SL | 26,352 | 0.0502 |
| SL>FF | 24,583 | 0.0469 |
| FF>CH | 19,252 | 0.0367 |
| CH>FF | 18,000 | 0.0343 |
| CH>CH | 15,187 | 0.0290 |
| ST>ST | 12,604 | 0.0240 |
| FC>FC | 12,176 | 0.0232 |
| SI>SL | 11,021 | 0.0210 |
| SL>SI | 10,961 | 0.0209 |
上位は同じ球種を続けたものばかりです. 4シームを続ける
FF>FF が 全2-gramの14%を占めます.
「同じ球種を続ける」全体でどれくらいでしょうか.
repeat_rate <- function(counts) {
  p <- tstrsplit(counts$ngram, ">")
  sum(counts$N[p[[1]] == p[[2]]]) / sum(counts$N)
}
obs_rep <- repeat_rate(g2)
35.75%です. 3球に1球以上は前と同じ球種です. これは「配球の型」でしょうか.
ベースラインを2段階で締める
型があるかどうかは, 何と比べるかで決まります. 弱いベースラインから順に締めます.
1. 投手の持ち球からバラバラに引く
その投手が1年で投げた球種の割合はそのままに, 順番を完全に壊します. 打席の中でどう固めていたかも消えます.
2. 打席の中だけでシャッフルする
打席ごとに, どの球種を何球投げたかは変えずに, 順番だけを入れ替えます. これが「並び方」だけを問う帰無仮説です.
set.seed(20260817)
B <- 20

null_pitcher <- replicate(B, repeat_rate(
  ngram_counts(shuffle_within_group(d$pitch_type, d$pitcher), d$pa, 2L)))
null_pa <- replicate(B, repeat_rate(
  ngram_counts(shuffle_within_group(d$pitch_type, d$pa), d$pa, 2L)))
res <- data.table(
ベースライン = c("観測", "投手内シャッフル (構成を壊す)", "打席内シャッフル (構成を保つ)"),
連投率 = c(obs_rep, mean(null_pitcher), mean(null_pa)),
sd = c(NA, sd(null_pitcher), sd(null_pa)))
res[, `観測との差(pp)` := 100 * (obs_rep - 連投率)]
res[, 連投率 := 100 * 連投率]
res[, sd := 100 * sd]
kable(res, digits = c(0, 3, 4, 3),
col.names = c("ベースライン", "連投率(%)", "sd(pp)", "観測との差(pp)"))| ベースライン | 連投率(%) | sd(pp) | 観測との差(pp) |
|---|---|---|---|
| 観測 | 35.745 | NA | 0.000 |
| 投手内シャッフル (構成を壊す) | 31.700 | 0.0579 | 4.045 |
| 打席内シャッフル (構成を保つ) | 35.841 | 0.0546 | -0.096 |
差がはっきり分かれました.
- 投手の持ち球からバラバラに引くと連投率は 31.7%. 観測は4.05ポイント高い (シャッフルのばらつき 0.058pp に対して 70倍)
- 打席の中だけでシャッフルすると連投率は 35.84%. 観測との差は-0.096ポイントしかなく, しかも符号が逆 (観測のほうがわずかに連投しない)
つまり 4.05ポイントあった「連投の構造」は, そのほぼ全部が打席の中の球種構成で説明できます. 順番そのものの寄与は 0.1ポイント以下です.
打席の中で投手は持ち球を絞ります (4シームとスライダーだけ, など). 絞った球を並べれば, 順番がどうであれ同じ球種は隣り合いやすくなります. 見えていたのはその効果でした.
2-gram の分布全体で見ても同じか
連投率は要約値の1つにすぎないので, 2-gram の分布全体でも確かめます.
sh_pa <- shuffle_within_group(d$pitch_type, d$pa)
g2_pa <- ngram_counts(sh_pa, d$pa, 2L)
cmp2  <- merge(g2, g2_pa, by = "ngram", suffixes = c(".obs", ".sh"), all = TRUE)
cmp2[is.na(N.obs), N.obs := 0][is.na(N.sh), N.sh := 0]
ggplot(cmp2, aes(N.sh, N.obs)) +
geom_abline(slope = 1, intercept = 0, colour = "grey60") +
geom_point(alpha = 0.6, colour = "steelblue") +
scale_x_log10(labels = scales::comma) +
scale_y_log10(labels = scales::comma) +
labs(x = "打席内シャッフルでの頻度", y = "観測された頻度",
title = "2-gram の頻度: 観測 vs 打席内シャッフル") +
theme_minimal()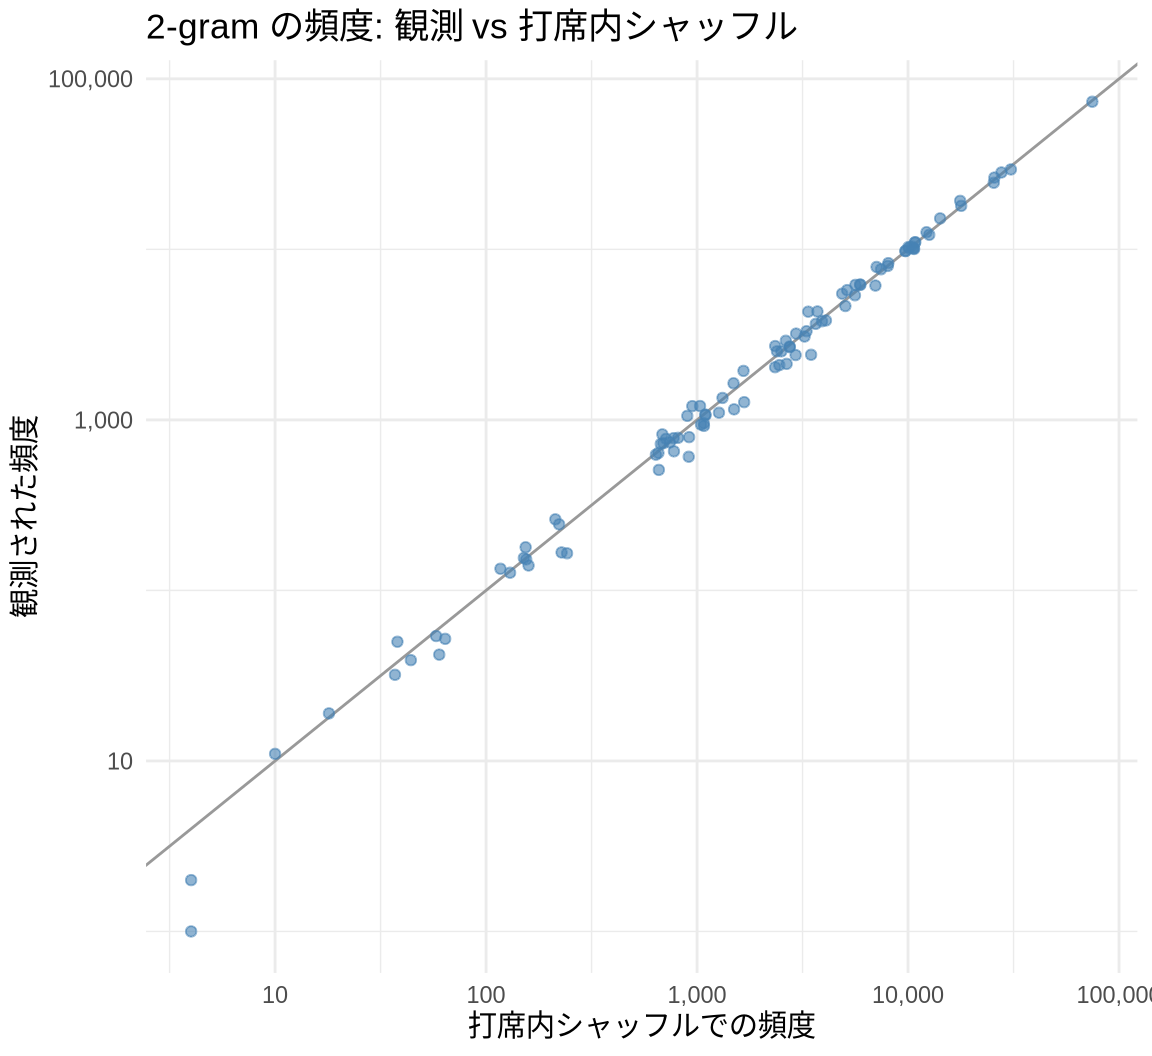
対角線に乗っています. エントロピーで比べても 観測5.3689 bit に対しシャッフルは 5.3712 bit で, 0.0023 bit しか違いません.
最大でどれくらいずれる並びがあるかを見ておきます.
cmp2[, 比 := (N.obs + 1) / (N.sh + 1)]
rbind(cmp2[N.obs >= 2000][order(-比)][1:5],
      cmp2[N.obs >= 2000][order(比)][1:5]) |>
  kable(digits = 3, format.args = list(big.mark = ","),
col.names = c("2-gram", "観測", "シャッフル", "比"))| 2-gram | 観測 | シャッフル | 比 |
|---|---|---|---|
| CU>CH | 4,311 | 3,365 | 1.281 |
| FC>CH | 4,324 | 3,719 | 1.163 |
| ST>CH | 2,710 | 2,346 | 1.155 |
| FS>FS | 5,497 | 4,874 | 1.128 |
| SL>CH | 5,770 | 5,146 | 1.121 |
| CH>CU | 2,410 | 3,472 | 0.694 |
| SL>FC | 2,131 | 2,657 | 0.802 |
| ST>FC | 2,399 | 2,932 | 0.818 |
| SL>CU | 2,095 | 2,454 | 0.854 |
| CH>ST | 2,036 | 2,344 | 0.869 |
よく投げられる並びに限っても, ずれは数%の範囲に収まります.
投手ごとの球種の多様性
並びに型が無いとしても, どれだけの種類を投げるかは投手ごとに違います.
MIN_PITCH <- 500
big <- d[, .N, by = pitcher][N >= MIN_PITCH, pitcher]

stat <- d[pitcher %in% big, {
  g1 <- ngram_counts(pitch_type, pa, 1L)
  ev <- events[events != "" & !is.na(events)]
  .(name = flip_name(player_name[1]), pitches = .N,
    H1 = shannon_entropy(g1$N),
    invS = inverse_simpson(g1$N),
    types = nrow(g1),
    PA = length(ev), K = sum(ev == "strikeout"),
    rv = mean(delta_run_exp, na.rm = TRUE))
}, by = pitcher]
stat[, Kpct := K / PA]
500球以上を投げた472投手が対象です.
ggplot(stat, aes(H1)) +
  geom_histogram(bins = 40, fill = "steelblue") +
  labs(x = "球種のエントロピー (bit)", y = "投手数") +
  theme_minimal()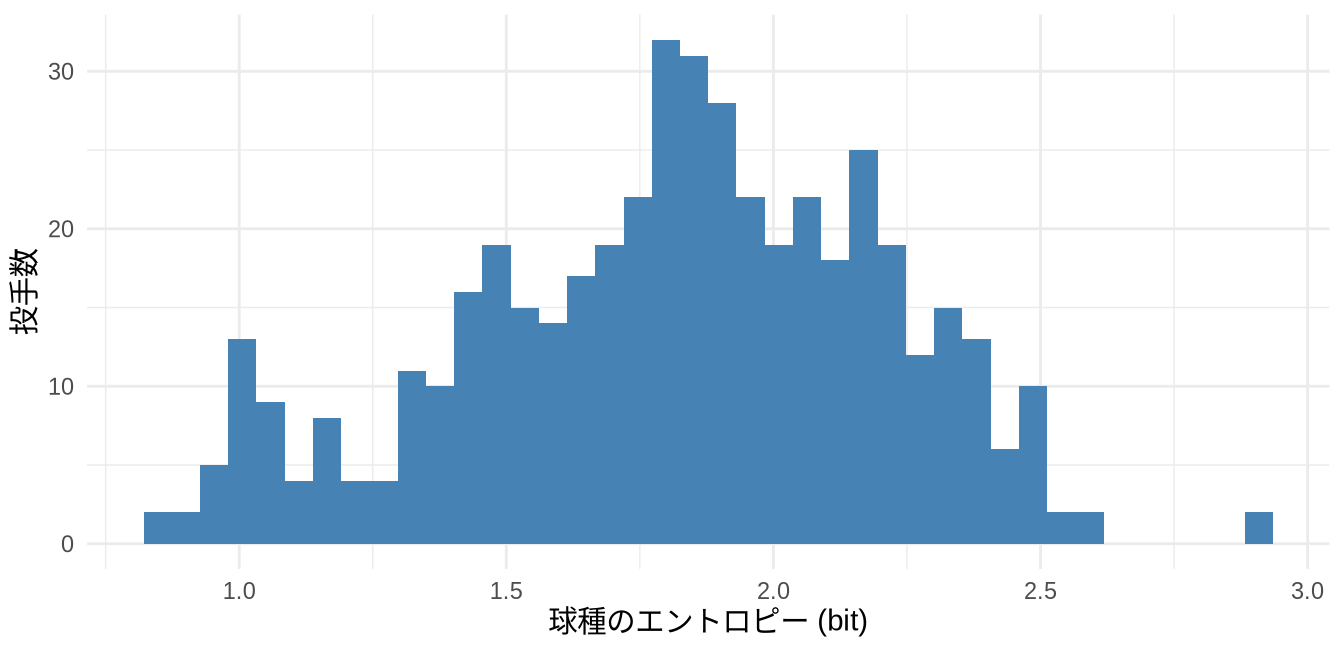
中央値1.84 bit (実効的な球種数 3.18種) です. 実際に投げた球種は中央値5種類なので, 持ち球の数ほどには使い分けていません.
両端を見ます.
rbind(stat[order(H1)][1:5], stat[order(-H1)][1:5])[
  , .(name, pitches, types, H1 = round(H1, 2), invS = round(invS, 2),
      Kpct = round(Kpct, 3))] |>
  kable(format.args = list(big.mark = ","),
col.names = c("投手", "球数", "球種数", "エントロピー", "実効球種数", "K%"))| 投手 | 球数 | 球種数 | エントロピー | 実効球種数 | K% |
|---|---|---|---|---|---|
| Emmanuel Clase | 983 | 3 | 0.85 | 1.54 | 0.245 |
| Kenley Jansen | 801 | 4 | 0.85 | 1.39 | 0.281 |
| Trevor Megill | 668 | 3 | 0.89 | 1.70 | 0.278 |
| Colin Poche | 543 | 2 | 0.90 | 1.77 | 0.219 |
| Josh Hader | 1,166 | 4 | 0.94 | 1.71 | 0.379 |
| Seth Lugo | 3,112 | 9 | 2.91 | 6.61 | 0.215 |
| Yu Darvish | 1,260 | 9 | 2.90 | 6.54 | 0.236 |
| Michael Lorenzen | 2,092 | 7 | 2.62 | 5.51 | 0.179 |
| Taijuan Walker | 1,435 | 7 | 2.57 | 5.40 | 0.152 |
| Paul Blackburn | 1,212 | 6 | 2.54 | 5.69 | 0.186 |
seq_narrow <- stat[which.min(H1)]
seq_wide   <- stat[which.max(H1)]
最も球種を絞っているのは Emmanuel Clase (エントロピー 0.85 bit, 実効球種数 1.54種) で, ほぼ2種類で投げ切っています. 最も散らしているのは Seth Lugo (2.91 bit, 実効球種数 6.61種) です.
多様性は成績と結びつくか
「球種が多いほうが打ちにくい」と言われます. 確かめます.
ct_k  <- cor.test(stat$H1, stat$Kpct)
ct_rv <- cor.test(stat$H1, stat$rv)
ggplot(stat, aes(H1, Kpct)) +
geom_point(alpha = 0.5, colour = "steelblue") +
geom_smooth(method = "lm", colour = "firebrick") +
labs(x = "球種のエントロピー (bit)", y = "奪三振率 (K%)") +
theme_minimal()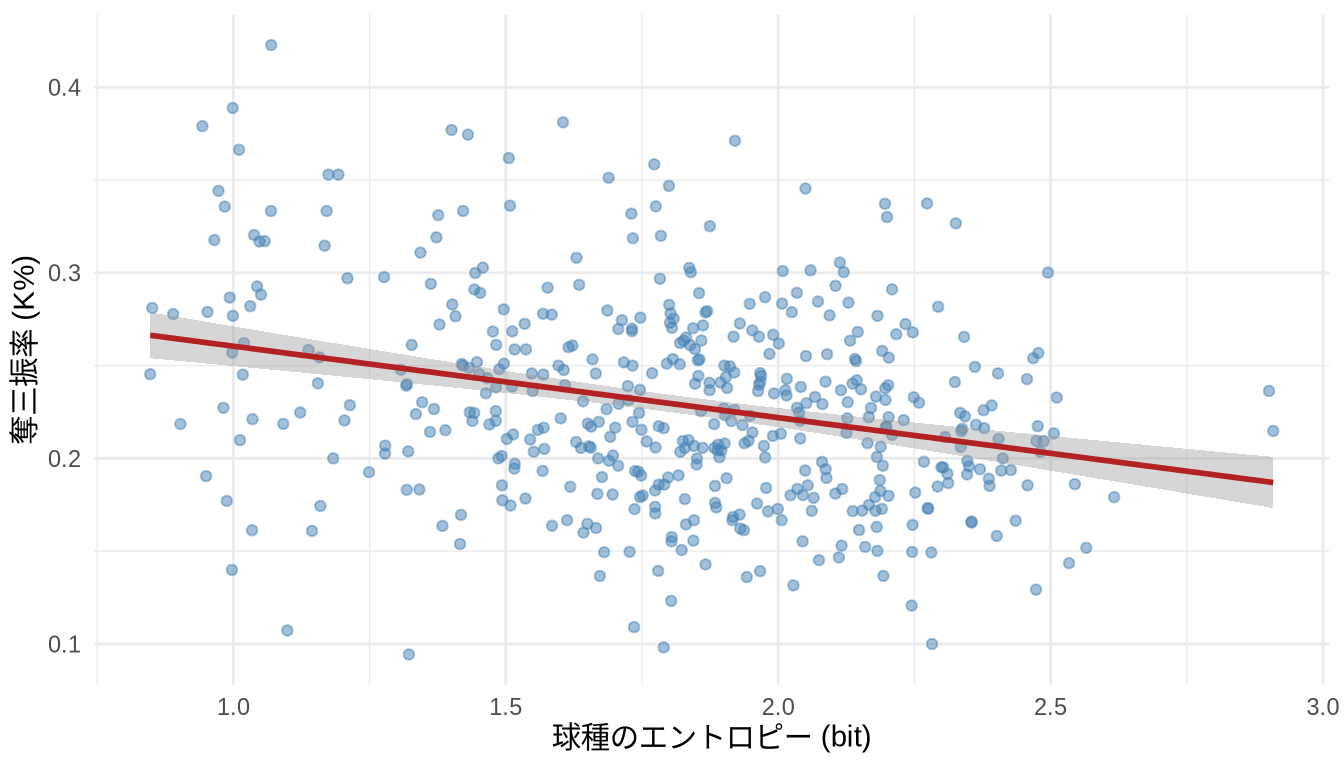
相関は r = -0.282 (95%信頼区間 -0.363 〜 -0.197) で, 負でした. 球種が多い投手ほど三振が少ない, という向きです.
1球あたりの得点価値 (delta_run_exp,
投手は小さいほど良い) でも同じ向きです. r = 0.213 (95%信頼区間 0.125 〜
0.297).
これを「球種を減らせば三振が増える」と読んではいけません. 交絡があります. 速球と1つの決め球で押し切れる投手はそもそも球威があり, 球種を増やす必要がありません. 逆に球威が足りない投手は球種で補います. エントロピーは球威の代理変数になってしまっています.
そもそも, 説明できている量は多くありません.
base_rmse <- sqrt(mean((stat$Kpct - mean(stat$Kpct))^2))
fit_rmse  <- sqrt(mean(residuals(lm(Kpct ~ H1, data = stat))^2))
「全員に平均の K% (22.9%) を答える」という 一番弱いベースラインの RMSE が 5.39pp, エントロピーを1つ入れたモデルが 5.17pp です. 改善は4.1%にすぎません.
rank-frequency は言語に似ているか
自然言語の n-gram は rank-frequency が直線 (Zipf 則) に乗ります. 球種でも見てみます.
g3 <- ngram_counts(d$pitch_type, d$pa, 3L)
stopifnot(sum(g3$N) == ngram_total(pa_len, 3L))
g3[, rank := .I]
zipf <- lm(log10(N) ~ log10(rank), data = g3[rank <= 200])
ggplot(g3, aes(rank, N)) +
geom_point(alpha = 0.5, colour = "steelblue") +
scale_x_log10() + scale_y_log10(labels = scales::comma) +
labs(x = "順位", y = "頻度", title = "3-gram の rank-frequency") +
theme_minimal()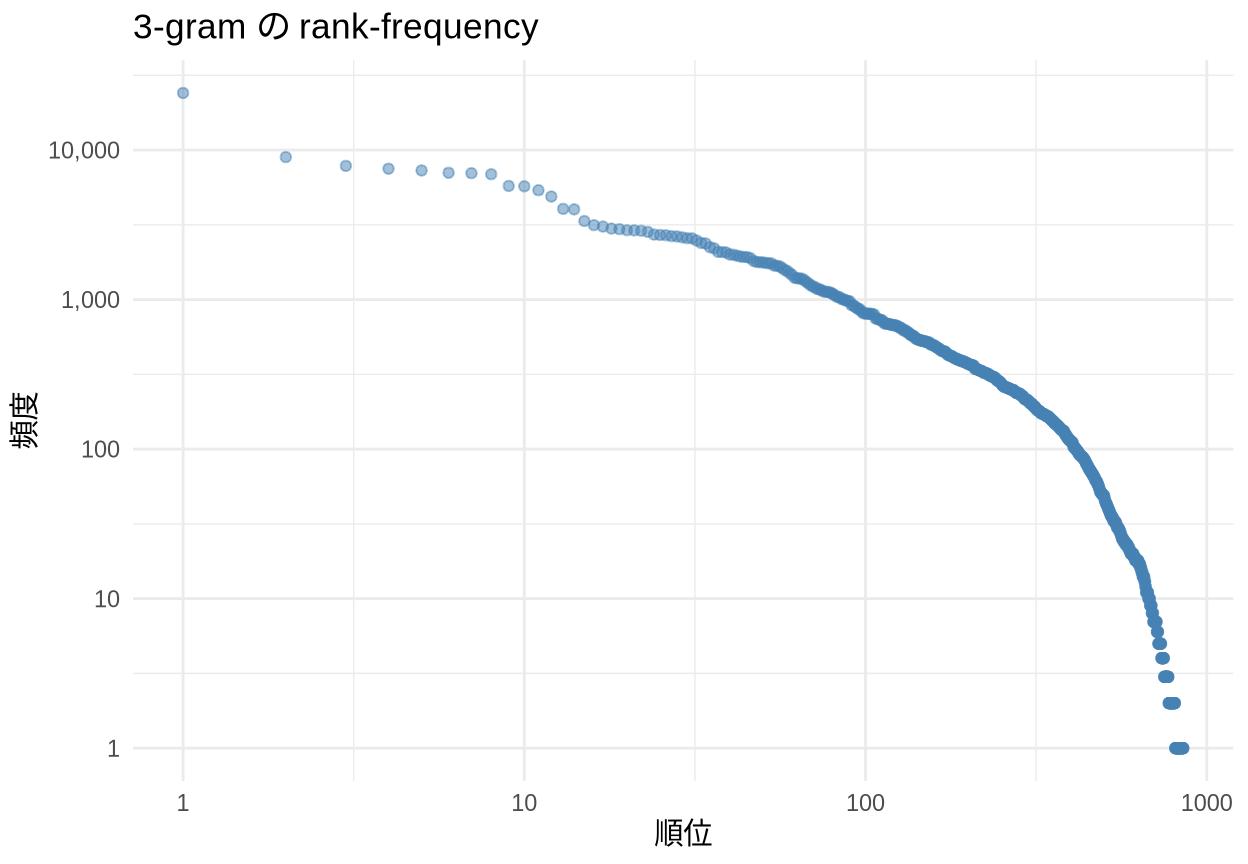
上位200件に直線を当てると傾き-0.838, R² = 0.963 です.
ただし この当てはまりの良さを言語との類似と読むのは無理があります. 球種は10種類しかないので, 3-gram はどう組み合わせても 高々1,000通り, 実際に出たのは854通りです. 語彙が数万ある自然言語と違い, 裾がほとんどありません. どんな分布でも上位を対数軸で見れば直線に近く見えます.
Heaps 則 (読んだ量を増やすと語彙が増え続ける) で見ると, これがはっきりします.
set.seed(11)
pa_order <- sample(unique(d$pa))
steps <- unique(round(exp(seq(log(50), log(length(pa_order)), length.out = 40))))
heaps <- rbindlist(lapply(steps, function(k) {
  sub <- d[pa %in% pa_order[1:k]]
  g <- ngram_counts(sub$pitch_type, sub$pa, 3L)
  data.table(打席数 = k, 投球数 = nrow(sub), 語彙 = nrow(g))
}))
ggplot(heaps, aes(投球数, 語彙)) +
geom_line(colour = "steelblue") + geom_point(colour = "steelblue") +
geom_hline(yintercept = nrow(g3), linetype = "dashed", colour = "grey50") +
scale_x_log10(labels = scales::comma) +
labs(x = "投球数 (対数)", y = "現れた 3-gram の種類",
title = "Heaps 則: 語彙は早々に頭打ちになる") +
theme_minimal()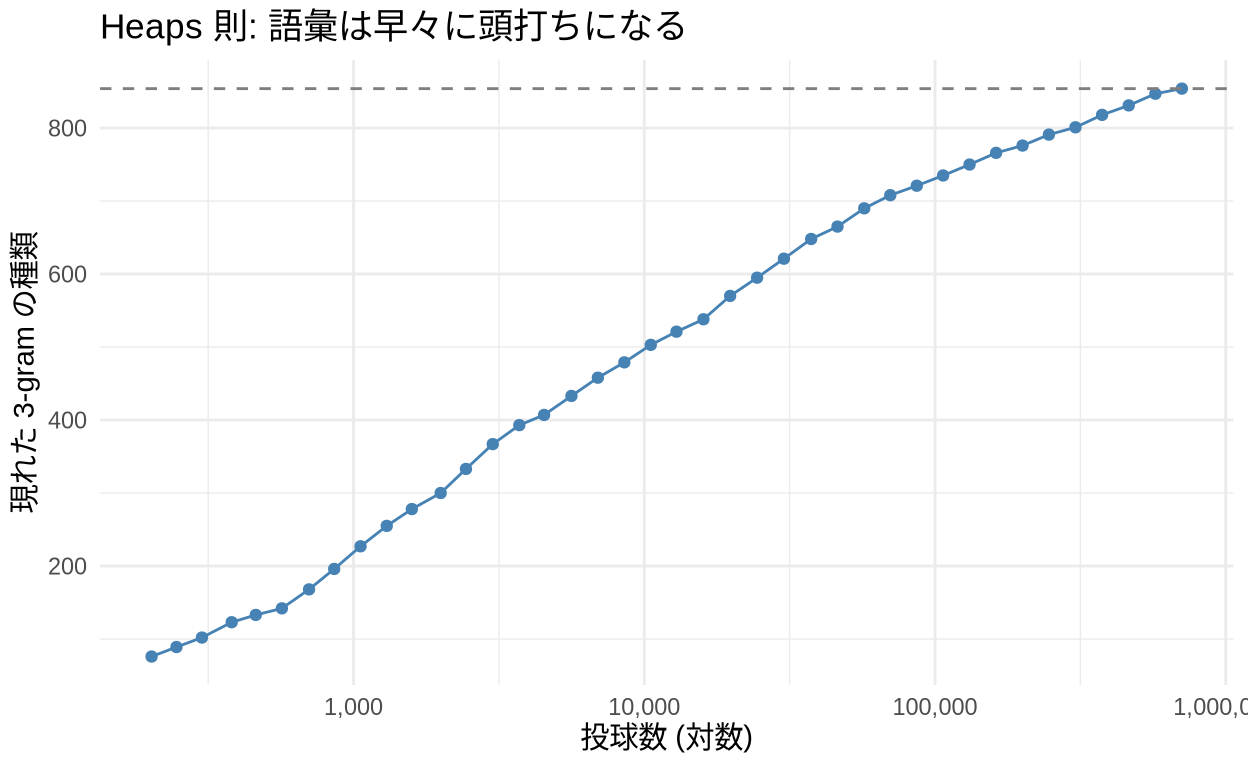
24,440球の時点で すでに595種類が出そろい, 残りの682,102球で 増えたのは259種類だけです. 自然言語の Heaps 則は両対数で直線が続きますが, ここは水平に寝ます. 配球は「語彙が有限で, すぐ数え尽くせる」系列であり, 言語と同じ道具立てで語ることには無理があります.
低頻度の型は信用できるか
シーズンを半分ずつに割って, 3-gram の順位がどれだけ再現するかを見ます.
set.seed(7)
pas  <- unique(d$pa)
half <- sample(pas, length(pas) %/% 2)
A <- ngram_counts(d[pa %in% half]$pitch_type,  d[pa %in% half]$pa,  3L)
Bh <- ngram_counts(d[!pa %in% half]$pitch_type, d[!pa %in% half]$pa, 3L)
m <- merge(A, Bh, by = "ngram", suffixes = c(".a", ".b"))
m[, `:=`(ra = frank(-N.a), rb = frank(-N.b))]

bands <- list(c(1, 50), c(51, 200), c(201, 500), c(501, nrow(m)))
stab <- rbindlist(lapply(bands, function(q) {
  s <- m[ra >= q[1] & ra <= q[2]]
  if (nrow(s) < 4) return(NULL)
  data.table(帯 = sprintf("%d-%d位", q[1], min(q[2], nrow(m))),
             種類 = nrow(s),
             中央頻度 = median(s$N.a),
             Spearman = cor(s$ra, s$rb, method = "spearman"))
}))
kable(stab, digits = 3, format.args = list(big.mark = ","))| 帯 | 種類 | 中央頻度 | Spearman |
|---|---|---|---|
| 1-50位 | 50 | 1,344.0 | 0.988 |
| 51-200位 | 148 | 331.0 | 0.983 |
| 201-500位 | 298 | 76.5 | 0.962 |
| 501-781位 | 281 | 8.0 | 0.832 |
上位は非常によく再現しますが, 裾は崩れます. 1-50位では Spearman 0.988 なのに対し, 501-781位 (中央頻度8件) では 0.832 まで落ちます.
つまり「1シーズンでは低頻度の型の順位が信用できない」という見込みは, 当たっている部分と外れている部分があります.
- 外れ: 上位201-500位あたりまでは Spearman 0.96 以上で安定している. 球種は10種類しかなく, 3-gram も854通りしか無いので, 364,179件を配ると上位には十分な観測が回る
- 当たり: 頻度が2桁を切る裾では順位が入れ替わる. ここを「よく現れる型」として並べてはいけない
したがって, 低頻度 motif のランキングを出すなら 頻度の下限を切る必要があります. このデータなら201-500位まで, おおむね中央頻度 76.5件あたりが目安です.
なお1シーズンで本当に足りなくなるのは, 素の 3-gram の順位よりも 打者・カウント・走者を条件づけたときの各セルの件数のほうです. 条件を1つ加えるたびに, この裾の問題が上位帯まで上がってきます.
限界
- 1シーズン (2024年) だけです. 年をまたぐ変化は見ていません
- 打者・カウント・走者で条件づけていません. 「2ストライクからは変化球」の ような条件つきの型は, ここでは打席内の構成に吸収されてしまいます. 条件つきの配球は別の記事にします
- 多様性と成績の関係は相関だけです. 球威との交絡を落としていません
- 打席内シャッフルは打席の構成を所与とします. 「どの球種を何球投げるか」を 決める過程そのものに型があるなら, この検定では見えません
まとめ
- よく出る並びは確かにある.
FF>FFだけで2-gram全体の 14% - しかし 打席の中で順番だけをシャッフルしても, 並びの頻度はほとんど変わらない (連投率の差 -0.096pp)
- 投手の持ち球全体と比べたときに見える 4.05pp の構造は, 打席内で持ち球を絞ることで説明できる
- 球種の多様性は奪三振率と負の相関 (r = -0.282, 95%CI -0.363 〜 -0.197). 球威との交絡なので因果とは読めない
- 3-gram の rank-frequency は直線に乗るが, 語彙が10種類しかないので 言語との類推は成り立たない
- 3-gram の順位は上位201-500位まで分割標本で安定する (Spearman 0.96 以上) が, 頻度が2桁を切る裾では0.83 まで落ちる. 型のランキングを出すなら頻度の下限を切る