同じ打球でも球場によって結果は変わるか
2026-08-18
「クアーズは打者有利」とはよく言われます. では 同じ打球 (同じ速度・同じ角度) を打ったとき, 球場によって結果は変わるでしょうか.
厄介なのは, 打球が安打になるかどうかは球場だけで決まらないことです. 守備が上手ければアウトになります. そして 球場効果と守備の効果は同じ残差を取り合います. 片方だけを推定すると, もう片方を吸い込んでしまいます.
先に結論です. 球場を無視して守備を測ると, 守備の推定は大きく狂います. 逆はほとんど起きません.
library(data.table)
library(dplyr)
library(ggplot2)
library(mgcv)
library(knitr)

SEASONS <- 2022:2024
src <- sprintf("../../data/statcast_%d_all.csv", SEASONS)
if (!all(file.exists(src))) {
  stop("データがありません: ", paste(src[!file.exists(src)], collapse = ", "),
       "\n  Rscript data/build-statcast.R ", min(SEASONS), " ", max(SEASONS),
       " --all-pitch-types")
}
dat <- rbindlist(lapply(SEASONS, function(y) {
  fread(sprintf("../../data/statcast_%d_all.csv", y),
        select = c("events", "launch_speed", "launch_angle",
                   "home_team", "away_team", "inning_topbot",
                   "batter", "game_pk", "bat_score", "fld_score"))[, season := y][]
}))
打球と塁打
打席が打球で終わったものだけを見ます. 犠打・失策も含め, そのプレーで打者が進んだ塁打数を結果とします.
TB <- c(field_out = 0, single = 1, double = 2, triple = 3, home_run = 4,
        force_out = 0, grounded_into_double_play = 0, sac_fly = 0,
        sac_bunt = 0, field_error = 0, double_play = 0,
        fielders_choice = 0, fielders_choice_out = 0,
        sac_fly_double_play = 0, triple_play = 0)

b <- dat[events %in% names(TB) & !is.na(launch_speed) & !is.na(launch_angle)]
b[, tb := TB[events]]
# 守備側は表なら本拠地チーム. 球場は本拠地チームで表す
b[, fld  := factor(fifelse(inning_topbot == "Top", home_team, away_team))]
b[, park := factor(home_team)]
b[, bat  := factor(batter)]
b[, yr   := factor(season)]
2022-2024年の 371,421打球です (30球場, 30チーム). 平均塁打は0.532でした.
b |> count(tb) |> mutate(割合 = n / sum(n)) |>
  kable(digits = 3, format.args = list(big.mark = ","),
col.names = c("塁打", "打球数", "割合"))| 塁打 | 打球数 | 割合 |
|---|---|---|
| 0 | 251,364 | 0.677 |
| 1 | 77,558 | 0.209 |
| 2 | 23,921 | 0.064 |
| 3 | 2,049 | 0.006 |
| 4 | 16,529 | 0.045 |
この設計は完全に交差しています. 各球場では30チームが守り, 各チームは30球場で守っています. だから球場と守備を分離できます.
打球の質から期待塁打を出す
m_q <- bam(tb ~ te(launch_speed, launch_angle, k = c(20, 20)) + yr,
           data = b, discrete = TRUE)
b[, xtb := predict(m_q, b)]
b[, resid := tb - xtb]
説明できた割合は48.9%です. 残差の合計は3.9e-12で, ほぼ0になっています (回帰の性質どおり).
grid <- CJ(launch_speed = seq(50, 115, length.out = 120),
           launch_angle = seq(-40, 60, length.out = 120))
grid[, yr := factor(2024, levels = levels(b$yr))]
grid[, xtb := predict(m_q, grid)]

ggplot(grid, aes(launch_speed, launch_angle, fill = xtb)) +
  geom_raster() +
  scale_fill_viridis_c(name = "期待塁打") +
  labs(x = "打球速度 (mph)", y = "打球角度 (度)",
       title = "打球の質から見た期待塁打") +
  theme_minimal()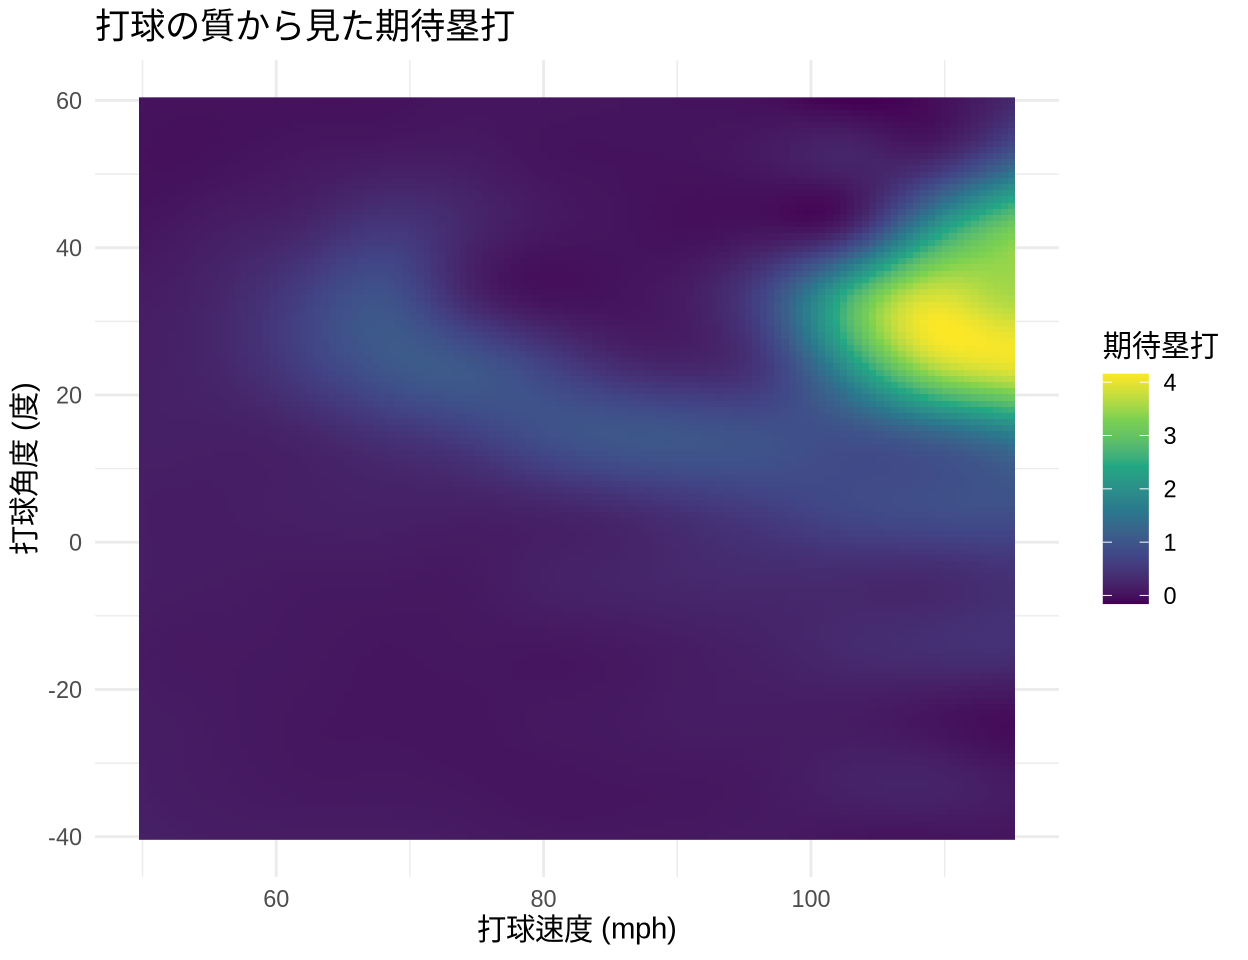
速度が出て角度が25〜30度あたりに入ると本塁打になる, という形が出ています.
球場と守備は同じ残差を取り合う
ここが記事の中心です. 3通りの推定を並べます.
ef <- function(m, pre, lv) {
  cf <- coef(m); k <- grep(paste0("^", pre), names(cf))
  v <- c(0, cf[k]); v <- v - mean(v); names(v) <- lv; v
}
LV_park <- levels(b$park); LV_fld <- levels(b$fld)

m_park <- lm(resid ~ park,       data = b)   # 球場だけ
m_fld  <- lm(resid ~ fld,        data = b)   # 守備だけ
m_both <- lm(resid ~ park + fld, data = b)   # 同時

park_alone <- ef(m_park, "park", LV_park)
park_joint <- ef(m_both, "park", LV_park)
fld_alone  <- ef(m_fld,  "fld",  LV_fld)
fld_joint  <- ef(m_both, "fld",  LV_fld)
まず, 単独で推定した球場効果と守備効果がどれくらい似ているかを見ます. 各チームの本拠地球場の効果と, そのチームの守備効果を突き合わせます.
r_conf <- cor(park_alone[LV_fld], fld_alone)相関は r = 0.706 でした. 別々に推定すると, この2つはほとんど同じものを測っています. 打球が抜けたのが球場のせいか守備のせいか, 区別できていません.
同時推定に切り替えると, どちらがどれだけ動くでしょうか.
tab <- data.table(
  効果 = c("球場", "守備"),
  単独のsd = c(sd(park_alone), sd(fld_alone)),
  同時のsd = c(sd(park_joint), sd(fld_joint)),
  `単独と同時の相関` = c(cor(park_alone, park_joint), cor(fld_alone, fld_joint)))
kable(tab, digits = 4)| 効果 | 単独のsd | 同時のsd | 単独と同時の相関 |
|---|---|---|---|
| 球場 | 0.0205 | 0.0217 | 0.9631 |
| 守備 | 0.0132 | 0.0120 | 0.6378 |
球場の推定はほとんど動きません (相関 0.963). 一方 守備の推定は大きく変わります (相関 0.638).
理由ははっきりしています. どのチームも半分の打球を自分の本拠地で守るので, 守備の推定に本拠地の球場特性が混ざります. 逆に球場のほうは 30チームぶんの守備が平均されて薄まります.
守備を測るときにこそ球場を入れなければいけない, ということです.
cmp <- data.table(team = LV_fld,
                  単独 = fld_alone, 同時 = fld_joint)
ggplot(cmp, aes(単独, 同時)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60") +
  geom_hline(yintercept = 0, colour = "grey85") +
  geom_vline(xintercept = 0, colour = "grey85") +
  geom_point(colour = "steelblue") +
  labs(x = "守備だけで推定 (1打球あたり塁打)",
       y = "球場と同時に推定",
       title = "守備の推定は球場を入れると動く") +
  theme_minimal()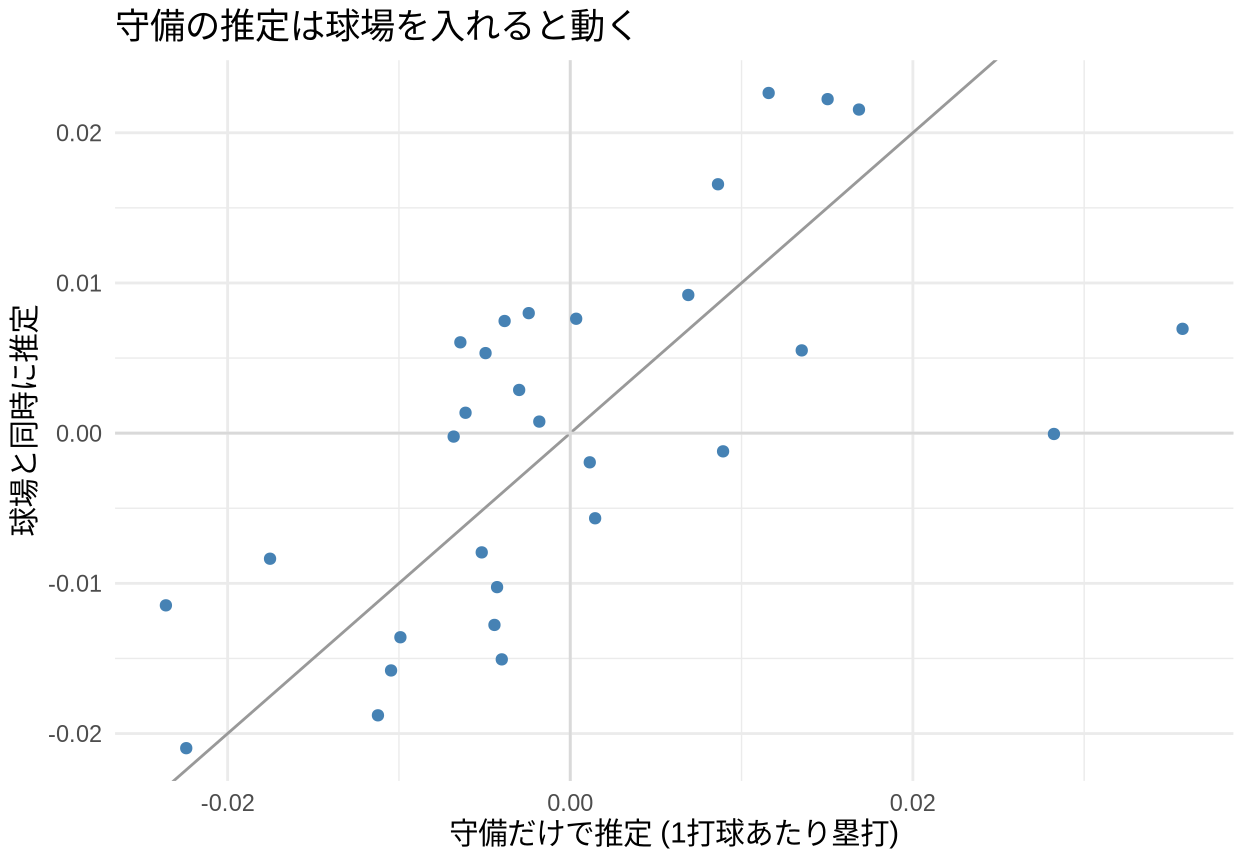
球場効果
pk <- data.table(球場 = LV_park, 同時 = park_joint,
                 球場だけ = park_alone[LV_park])
setorder(pk, -同時)
rbind(head(pk, 6), tail(pk, 6)) |>
kable(digits = 4, col.names = c("球場 (本拠地チーム)", "同時推定", "球場だけ"))| 球場 (本拠地チーム) | 同時推定 | 球場だけ |
|---|---|---|
| CIN | 0.0584 | 0.0618 |
| COL | 0.0540 | 0.0543 |
| BOS | 0.0217 | 0.0196 |
| LAD | 0.0199 | 0.0133 |
| TB | 0.0174 | 0.0075 |
| PHI | 0.0173 | 0.0212 |
| DET | -0.0212 | -0.0269 |
| SF | -0.0214 | -0.0132 |
| ATH | -0.0220 | -0.0113 |
| KC | -0.0227 | -0.0204 |
| STL | -0.0246 | -0.0218 |
| PIT | -0.0252 | -0.0213 |
1打球あたりの塁打で表しています. 1チーム1試合あたりの打球数は 25.5本なので, 最も打者有利な球場と不利な球場の差は1試合1チームあたり 2.13塁打になります.
打者を調整に入れるか
打球の質を押さえてあるので打者の影響は大きくないはずですが, 確かめます.
m_bat <- bam(resid ~ park + fld + s(bat, bs = "re"), data = b, discrete = TRUE)
cf <- coef(m_bat); k <- grep("^park", names(cf))
park_bat <- c(0, cf[k]); park_bat <- park_bat - mean(park_bat)
r_bat <- cor(park_bat, park_joint)
打者を変量効果で入れても球場効果はほとんど変わりません (相関 0.9884, sd は 0.0217 から 0.0215 へ). 期待塁打で打球の質を押さえた時点で, 打者の質はおおむね吸収されています.
得点で測るパークファクターと並べる
従来のパークファクターは得点で作ります. 同じデータから作って比べます.
MLB 公式のパークファクターはこのリポジトリに入っていないので, 同じ3シーズンの得点から自前で計算します (その球場での1試合平均得点 ÷ 全体の1試合平均得点).
g  <- dat[, .(runs = max(bat_score + fld_score, na.rm = TRUE)),
          by = .(game_pk, home_team)]
pf <- g[, .(得点 = mean(runs), 試合 = .N), by = home_team]
pf[, PF := 得点 / mean(g$runs)]
pf <- merge(pf, data.table(home_team = LV_park, 打球残差 = park_joint),
            by = "home_team")
r_pf <- cor(pf$PF, pf$打球残差)
ggplot(pf, aes(PF, 打球残差)) +
geom_hline(yintercept = 0, colour = "grey85") +
geom_vline(xintercept = 1, colour = "grey85") +
geom_text(aes(label = home_team), size = 3, colour = "steelblue") +
labs(x = "得点で作ったパークファクター", y = "打球残差で作った球場効果",
title = "同じ球場でも2つの指標は一致しない") +
theme_minimal()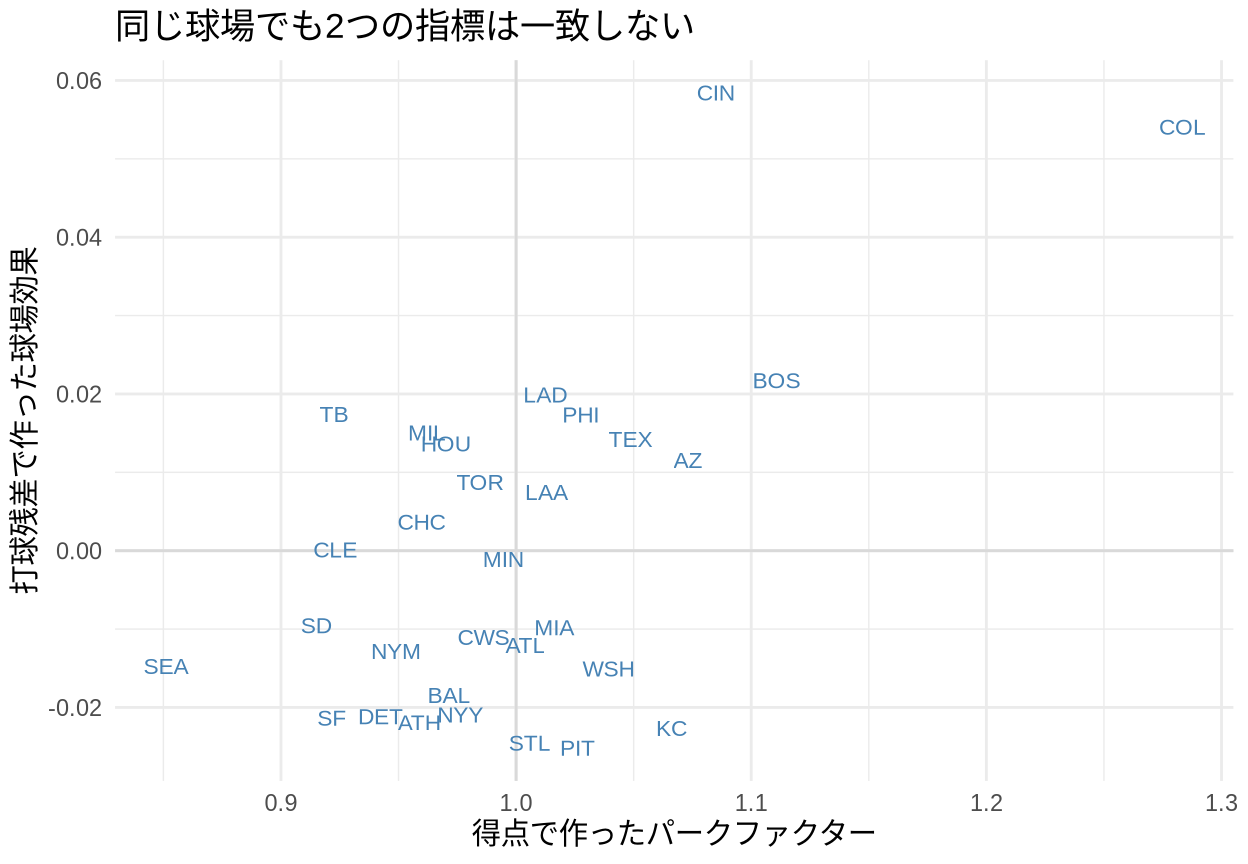
相関は r = 0.57 で, 一致とは言えません.
setorder(pf, -打球残差)
rbind(head(pf, 4), tail(pf, 4))[
  , .(home_team, 得点 = round(得点, 2), PF = round(PF, 3),
      打球残差 = round(打球残差, 4))] |>
kable(col.names = c("球場", "1試合平均得点", "得点PF", "打球残差の球場効果"))| 球場 | 1試合平均得点 | 得点PF | 打球残差の球場効果 |
|---|---|---|---|
| CIN | 9.49 | 1.085 | 0.0584 |
| COL | 11.23 | 1.283 | 0.0540 |
| BOS | 9.72 | 1.111 | 0.0217 |
| LAD | 8.86 | 1.012 | 0.0199 |
| ATH | 8.39 | 0.959 | -0.0220 |
| KC | 9.33 | 1.066 | -0.0227 |
| STL | 8.80 | 1.006 | -0.0246 |
| PIT | 8.98 | 1.026 | -0.0252 |
食い違いは当然です. 得点は四球・三振・走塁・その試合で戦ったチームの質を すべて含みます. 打球残差は 同じ打球がどうなるか だけを見ています.
kc <- pf[home_team == "KC"]KC が分かりやすい例です. 得点PFは1.066と平均より高いのに, 打球残差の球場効果は-0.0227とマイナスです. 得点が入りやすい球場が, 打球を安打にしやすい球場とは限りません.
どこまで信用できるか
推定のばらつきを確かめます. まずノイズだけでどれくらい一致するかの上限を 出します. 打球を無作為に半分ずつ割って, 別々に球場効果を推定して比べます.
set.seed(47)
noise <- replicate(5, {
  i <- sample(c(TRUE, FALSE), nrow(b), replace = TRUE)
  a <- ef(lm(resid ~ park + fld, data = b[i]),  "park", LV_park)
  c2 <- ef(lm(resid ~ park + fld, data = b[!i]), "park", LV_park)
  cor(a, c2)
})
無作為半分割の相関は平均0.802 (範囲 0.73〜0.849) でした. これがこのデータ量での上限です.
次に, ホームの打者だけ / アウェイの打者だけで球場効果を推定して比べます. 球場が純粋に球場の性質なら, どちらから測っても同じになるはずです.
park_home <- ef(lm(resid ~ park + fld, data = b[inning_topbot == "Bot"]),
                "park", LV_park)
park_away <- ef(lm(resid ~ park + fld, data = b[inning_topbot == "Top"]),
                "park", LV_park)
r_ha <- cor(park_home, park_away)
相関は0.647でした. ノイズの上限 0.802 を明らかに下回っています. 符号が反転するようなことは起きていませんが, 一致もしていません.
つまり 球場効果は純粋に球場だけの性質ではありません. 本拠地チームは自分の球場に合わせて打者を集めますし, 慣れもあります. ここで測っているのは「球場 + その球場を本拠地にするチームの打者の傾向」です.
限界
- 球場効果と本拠地チームの打者編成を分けられていません (上記). 分けるには複数年にわたる選手の移籍を追う必要があります
- 守備はチーム単位までです. 個々の野手の評価はしていません (非スコープどおり)
- 打球の質は打球速度と角度だけで測っています. 打球方向
(
spray angle) はdata/build-statcast.Rの取得列に無いので使えません. 左右非対称な球場 (フェンウェイなど) の効果はここでは十分に表せません - 気温・湿度・標高の分解はしていません (非スコープどおり). クーロアーズの効果は標高由来ですが, ここでは球場効果としてまとめて出ています
- MLB 公式のパークファクターではなく, 同じデータから作った得点PFと比べています
- 2022-2024年の3シーズンです. 球場の改修は考慮していません
まとめ
- 371,421打球の期待塁打を打球速度と角度から出し, 残差を球場とチーム守備に同時に分けた (残差の合計は 3.9e-12 でほぼ0)
- 別々に推定すると球場効果と守備効果は r = 0.706 で, ほぼ同じものを測ってしまう
- 同時推定にすると球場はほとんど動かない (相関 0.963) が, 守備は大きく動く (相関 0.638). 球場を入れずに守備を測ってはいけない
- 球場効果の幅は1試合1チームあたり 2.13塁打
- 打者を変量効果で入れても球場効果は変わらない (相関 0.9884)
- 得点で作るパークファクターとの相関は r = 0.57 にとどまる. 得点が入る球場と, 打球が安打になる球場は別のもの
- ホーム打者とアウェイ打者から測った球場効果は 0.647 しか一致せず, ノイズの上限0.802を下回る. 球場効果には本拠地チームの打者編成が混ざっている