球速が変わったのはいつか
2026-08-12
「いつ落ちた」を目で見ないで決める
投手の球速が落ちた, 戻った, という話は時系列を眺めて語られます. これを手続きにします.
1本の時系列に対し, どこかに段差があるかを決め, あるならその位置を返す. やることはこれだけです. 難しいのは検出そのものではなく, 見つかった変化点を どこまで信じるかのほうです.
library(data.table)
library(dplyr)
library(ggplot2)
source("../../R/statcast.R")

MIN_PITCH <- 10   # 1試合でこの球数以上投げた試合だけ使う
MIN_GAME  <- 20   # この試合数以上ある投手だけ対象にする
MIN_SEG   <- 5    # 変化点の前後に最低これだけの試合を要求する
対象は2024年の直球 (FF) の球速です. 1試合ぶんの平均を1点として並べます.
d  <- fread("../../data/statcast_2024_all.csv", showProgress = FALSE)
ff <- d[pitch_type == "FF" & !is.na(release_speed)]

gm <- ff[, .(v = mean(release_speed), np = .N),
         by = .(pitcher, player_name, game_date)][np >= MIN_PITCH]
gm[, player_name := flip_name(player_name)]
setorder(gm, pitcher, game_date)
keep <- gm[, .N, by = pitcher][N >= MIN_GAME]$pitcher
gm <- gm[pitcher %in% keep]
151人の投手, 合計4,196試合ぶんです (1人あたり中央値28試合).
検出のしかた
考えられるすべての切り方を試し, 前半と後半の差が一番大きくなる位置を取ります. 差の大きさは二標本 t 統計量で測ります (試合数の違いを吸収するため).
scan_cp <- function(x, min_seg = MIN_SEG) {
  n <- length(x)
  k <- min_seg:(n - min_seg)              # 端すぎる切り方は許さない
  if (!length(k)) return(list(stat = 0, at = NA, delta = 0))
  cs <- cumsum(x); tot <- cs[n]
  m1 <- cs[k] / k                          # 前半の平均
  m2 <- (tot - cs[k]) / (n - k)            # 後半の平均
  s2 <- (sum(x^2) - tot^2 / n) / (n - 1)
  t  <- abs(m1 - m2) / sqrt(s2 * (1/k + 1/(n - k)))
  i <- which.max(t)
  list(stat = t[i], at = k[i], delta = m2[i] - m1[i])
}
stat を普通の t 分布と比べてはいけません.
一番大きくなる位置を選んでから 検定しているので,
選んだぶんだけ値が大きく出ます.
比べる相手は自分で作ります. 同じ値の集合のまま順番だけを無作為に入れ替えて, 同じ手続きで最大の統計量を出す. これが「変化点は無い」世界です.
perm_p <- function(x, B = 1000, min_seg = MIN_SEG) {
  obs <- scan_cp(x, min_seg)
  if (is.na(obs$at)) return(c(p = NA, at = NA, delta = NA))
  null <- replicate(B, scan_cp(sample(x), min_seg)$stat)
  c(p = (1 + sum(null >= obs$stat)) / (B + 1),
    at = obs$at, delta = obs$delta)
}
先に検出器を検査する
投手に当てる前に, 答えの分かっている系列で2つ確かめます.
変化が無いときに何割で騒ぐか
set.seed(1)
sd_typ <- median(gm[, .(s = sd(v)), by = pitcher]$s)

fp <- replicate(300, perm_p(rnorm(med_g, 94, sd_typ), B = 300)["p"])
投手の試合間のばらつきは中央値で0.67 mph です. その大きさの 雑音だけを並べた, 段差がまったく無い系列を300本作って当てると, p < 0.05 になったのは4.3%でした. 名目の5%とほぼ一致します. 置換で校正しているので, ここが合わないなら手続きが間違っています.
段差があるときに見つかるか
set.seed(2)
STEP <- 1.5
hit <- replicate(200, {
  x <- c(rnorm(15, 94, sd_typ), rnorm(med_g - 15, 94 - STEP, sd_typ))
  r <- perm_p(x, B = 300)
  c(det = unname(r["p"] < 0.05), near = unname(abs(r["at"] - 15) <= 2))
})
16試合目から1.5 mph 落ちる系列では, 100%で検出でき, 検出できたもののうち96%は位置が±2試合以内でした. この大きさの段差なら, 位置まで含めて信用できます.
全員に当てる
set.seed(3)
res <- gm[, {
  r <- perm_p(v)
  .(n = .N, p = r["p"], at = r["at"], delta = r["delta"],
    when = game_date[r["at"]])
}, by = .(pitcher, player_name)]
p < 0.05 になったのは77人 / 151人, 51%です.
半数の投手に「シーズン中に球速が変わった瞬間」がある, というのが素直な読み方ですが, その読み方は使えません. 偽陽性は5%に抑えてあるので, これは偽陽性ではありません. 起きているのは別のことです. 球速は本当に動いていて, 検出器はそれを正しく 拾っている. ただしその多くは, わざわざ「変化点」と呼ぶほどの大きさではないのです.
意味のある大きさを先に決める
有意かどうかと, 意味があるかどうかは別です. 段差の大きさ δ に下限を置きます.
thr <- data.frame(δ = c(0, 0.5, 1.0, 1.5)) %>%
  mutate(該当人数 = sapply(δ, function(D)
sum(res$p < 0.05 & abs(res$delta) >= D, na.rm = TRUE)))| δ | 該当人数 |
|---|---|
| 0.0 | 77 |
| 0.5 | 77 |
| 1.0 | 37 |
| 1.5 | 8 |
51%という数字は, δ = 1.0 mph で37人 (25%), δ = 1.5 mph で8人 (5%) まで落ちます.
δ をいくつにするかは統計の問題ではありません. 1.5 mph の低下を編成上の判断に 使うのかどうかという, 現場の側の決めごとです. 決めずに p 値だけを見ると, 半数の投手が「変わった」ことになります.
res %>% filter(!is.na(p)) %>%
  mutate(判定 = ifelse(p < 0.05, "p < 0.05", "p ≥ 0.05")) %>%
  ggplot(aes(x = delta, fill = 判定)) +
  geom_histogram(bins = 40) +
  geom_vline(xintercept = c(-1, 1), linetype = "dashed") +
  xlab("段差 (mph, 正なら後半のほうが速い)") + ylab("投手数") +
  ggtitle("見つかった段差の大きさ (破線は ±1.0 mph)")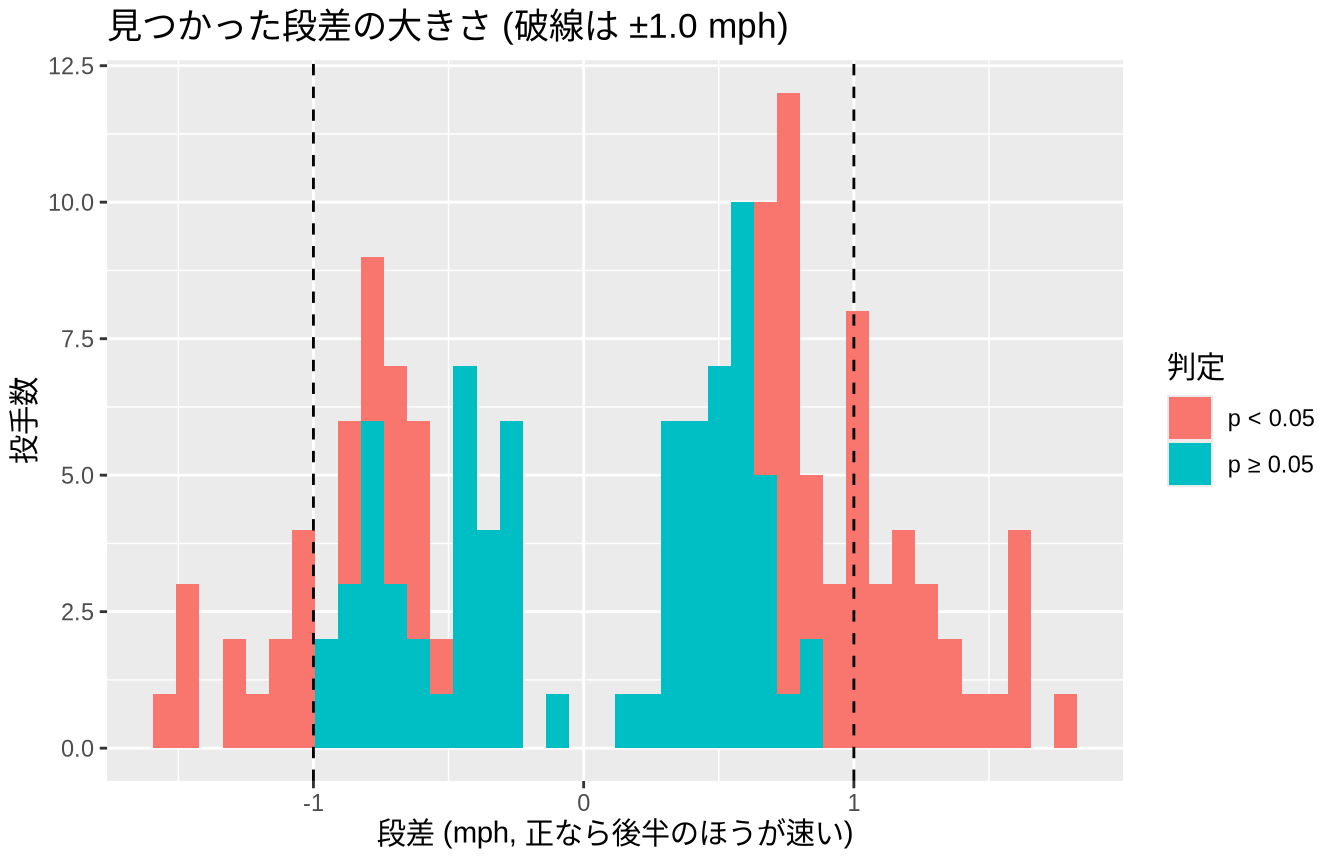
リーグ全体の季節変動を差し引く
49人が「上がった」, 28人が「下がった」でした. 上がった側に偏っています. 個人の事情がそろって上向きになる理由は無いので, 全体で動いているものを疑います.
gm[, pmean := mean(v), by = pitcher]
gm[, dev := v - pmean]                      # 各投手の自分の平均からの差
lgd <- gm[, .(lg = mean(dev)), by = game_date]
ggplot(lgd, aes(x = game_date, y = lg)) +
geom_hline(yintercept = 0, linetype = "dashed") +
geom_point(alpha = 0.4) + geom_smooth(se = FALSE) +
xlab("") + ylab("自分の平均からの差 (mph)") +
ggtitle("対象投手の平均球速はシーズンを通して上がる")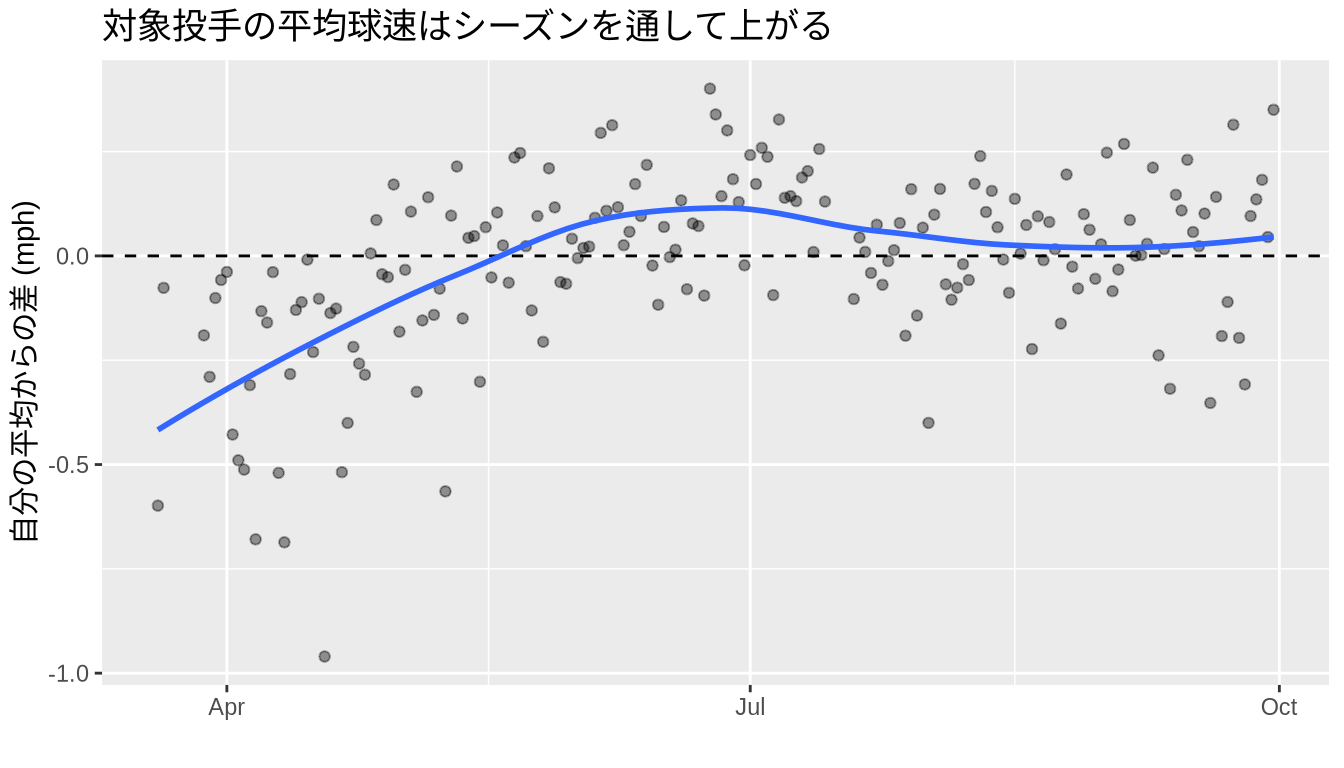
4月は自分の平均より-0.21 mph 遅く, 6月は+0.10 mph 速い. 幅は0.31 mph です. 全員が同じ向きに動くので, 個人の系列にはこれが段差として乗ります.
その日のリーグ全体の偏差を引いてから, 同じ手続きをやり直します.
gm[lgd, on = "game_date", v_adj := pmean + (dev - i.lg)]

set.seed(4)
res_adj <- gm[, {
  r <- perm_p(v_adj)
  .(n = .N, p = r["p"], at = r["at"], delta = r["delta"],
    when = game_date[r["at"]])
}, by = .(pitcher, player_name)]| 補正 | p<0.05 | 上がった | 下がった | δ1.0以上 | δ1.5以上 |
|---|---|---|---|---|---|
| なし | 77 | 49 | 28 | 37 | 8 |
| あり | 76 | 36 | 40 | 29 | 3 |
結果は一様ではありません.
- 検出される人数はほとんど変わりません (77人 → 76人). 個々の投手の中で球速が動いていること自体は, 季節変動では説明されません.
- 向きの偏りは消えます (上49:下28 → 上36:下40). 偏りはリーグ全体の立ち上がりでした.
- 大きい変化は減ります (δ1.5以上が8人 → 3人). 季節変動のぶんが個人の段差に上乗せされていました.
「何人変わったか」は補正に対して頑健でも, 「誰がどれだけ変わったか」は動きます. 順位や個人の数字を出すなら, 補正してからにしてください.
個別に見る
補正後も大きい段差が残った投手を並べます.
| 投手 | 試合数 | 変化点 | 段差 | p |
|---|---|---|---|---|
| Bryan Hudson | 27 | 2024-07-11 | -1.61 | 0.001 |
| Slade Cecconi | 20 | 2024-07-10 | 1.52 | 0.001 |
| Bowden Francis | 22 | 2024-08-24 | -1.50 | 0.009 |
| Zac Gallen | 27 | 2024-05-07 | 1.44 | 0.001 |
| Cole Ragans | 32 | 2024-06-24 | -1.41 | 0.001 |
| Luke Weaver | 35 | 2024-04-24 | 1.40 | 0.001 |
最も大きな段差が残ったのは Bryan Hudson です. 2024-07-11 を境に球速が -1.61 mph 動きました (リーグ全体の季節変動を引いた後の値).
show <- gm[pitcher %in% top$pitcher]
show <- merge(show, top[, .(pitcher, when, delta)], by = "pitcher")

ggplot(show, aes(x = game_date, y = v_adj)) +
  geom_line(alpha = 0.5) + geom_point(size = 0.9) +
  geom_vline(aes(xintercept = when), colour = "red", linetype = "dashed") +
  facet_wrap(~ player_name, scales = "free_y") +
  xlab("") + ylab("直球の平均球速 (mph, リーグ補正後)") +
  ggtitle("検出された変化点 (赤破線)")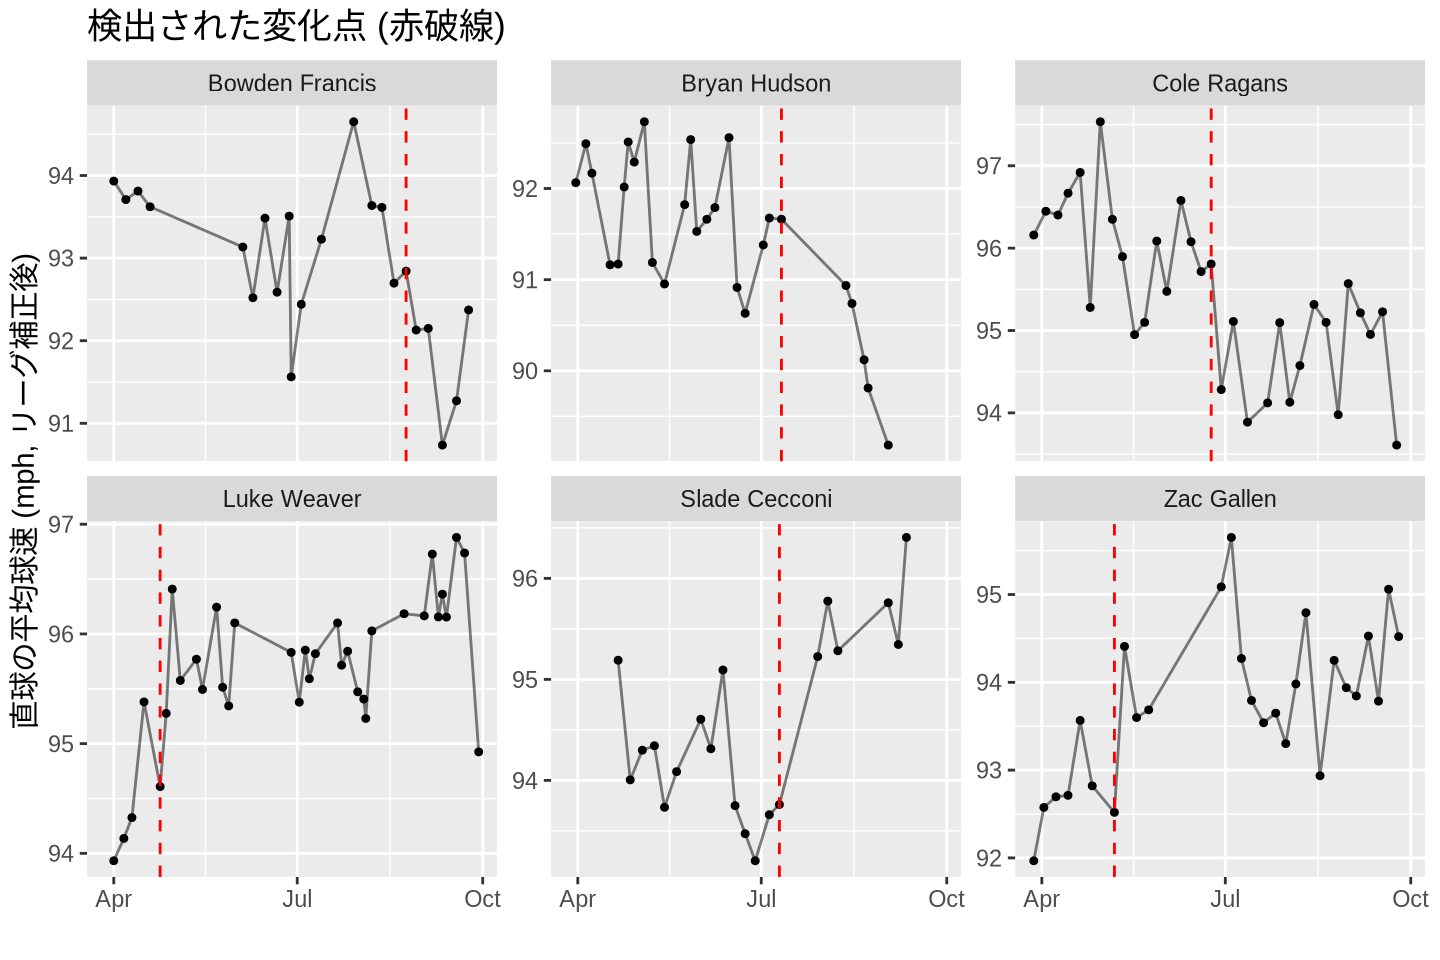
前後の分布も見ます. 平均が動いたのか, ばらつきが変わっただけなのかは別の話です.
show[, 区間 := ifelse(game_date < when, "変化点より前", "変化点より後")]

ggplot(show, aes(x = v_adj, fill = 区間)) +
  geom_density(alpha = 0.45) +
  facet_wrap(~ player_name, scales = "free") +
  xlab("直球の平均球速 (mph, リーグ補正後)") + ylab("密度") +
  ggtitle("変化点の前後の分布")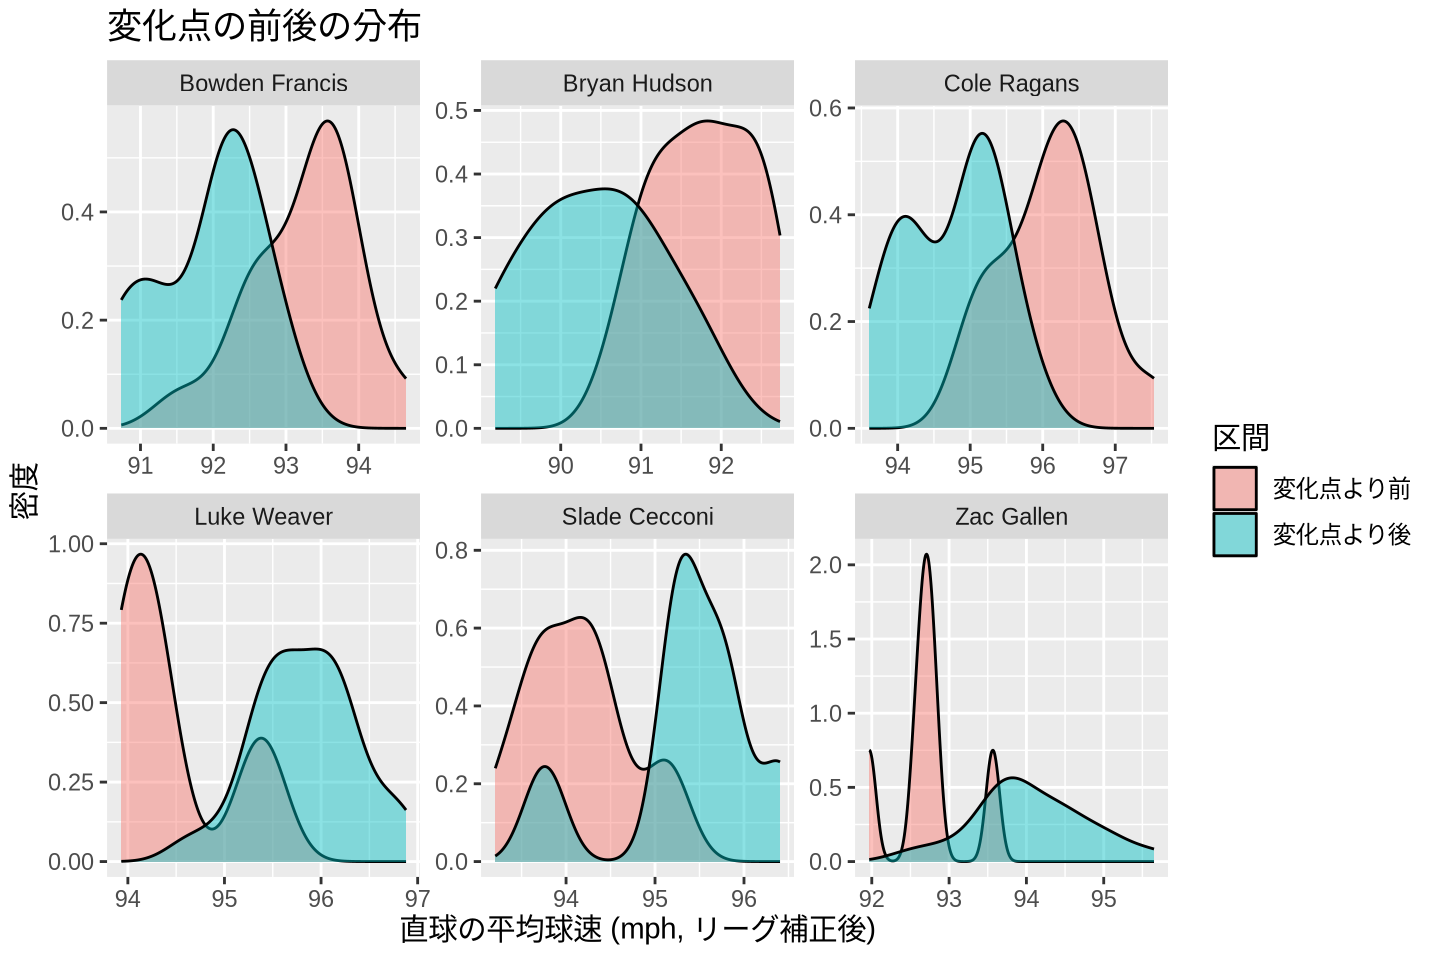
注意
- 見つかるのは「1本の系列に段差を1つ入れるならどこか」だけです. 段差が複数 あっても1つしか返しませんし, 段差ではなく緩やかな下降でも, どこかで切って 段差だと答えます. 図で形を確かめてください.
- 変化の原因までは分かりません. 故障, フォーム変更, 起用法 (先発から救援へ) のどれでも同じ段差になります. 検出は原因を探す入口であって, 答えではありません.
- 1試合の平均を1点にしているので, 登板間隔や球数はならしています. 中4日と中6日, 20球と100球を同じ重みで扱っています.
- 対象は20試合以上投げた投手だけです. シーズン途中で消えた投手は 入っていません. 球速が落ちて登板が無くなった投手ほど外れるので, 大きな低下は実際より少なく見えているはずです.
- 直球の球速だけを見ています. 打者側の指標 (空振り率, 追いかけ率)
も同じ手続きで 扱えますが, 打席単位の系列を組むには
game_pkなどの列が要ります (data/build-statcast.Rの取得列に入っていません). - 2024年の1シーズンだけです. 年をまたぐ変化 (オフの間に落ちた) は見ていません.
関連
- 制球力はどう測るべきか — 同じ Statcast データで, 指標の安定性を先に確かめる話
- 打者は何歳でピークを迎えるか — 年単位の緩やかな変化と, 並べ替え検定の使い方
- 変化量が大きい球ほど空振りするのか — 同じ Statcast の直球データ